Agent Skill自演进
Reflexion
[2303.11366] Reflexion: Language Agents with Verbal Reinforcement Learning
Reflexion 让 Agent 将任务反馈转化为自然语言反思,并通过长期记忆在后续尝试中修正行为,而不更新模型参数
核心思想
如果 Agent 执行失败,普通 ReAct 可以再次尝试,但没有一个机制把上一次的失败转换为知道下一次应该怎么做
传统 RL可以理解为:
论文把这种语言反馈形容为一种 semantic gradient(语义梯度),为后续尝试提供改进方向;这是类比,不涉及模型参数的梯度更新
整体框架
把 Reflexion 划分成三个功能组件:
- Actor
- Evaluator
- Self-Reflection
除此之外还有一个极其重要的组件 Memory
核心架构图:
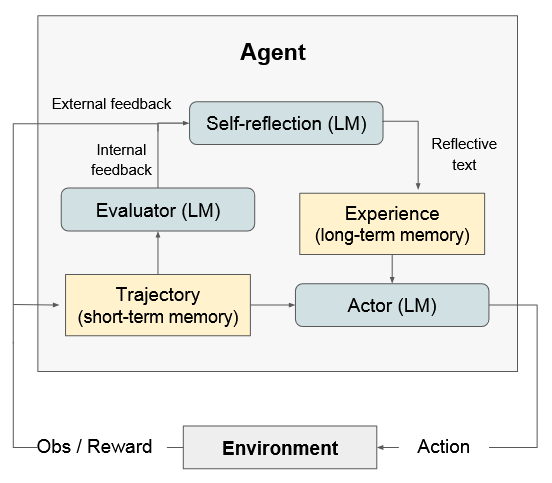
Trial 内:Actor ↔ Environment,负责把任务做完。
Trial 间:Evaluator → Self-reflection → Experience,负责从上一轮吸取经验
Trial:Agent 对同一任务的一次完整执行过程
Trajectory:当前一次任务执行的完整/部分交互历史,短期记忆
- External feedback:来源于 Environment,直接反馈结果信息
- Internal feedback:由 Evaluator 根据 Trajectory 产生评价信号;Evaluator 可以是规则、测试或 LLM,原因分析由 Self-reflection 完成
Self-reflection (LM):综合 Trajectory + External feedback + Internal feedback 得到Reflective text
而后被存入 Experience (long-term memory),这些经验会给下一轮的 Actor 使用
上一轮 Trial 的失败,被转化成文字经验,影响下一轮 Trial 的行为
局限与我的思考
- 主要复用自然语言反思,未形成可直接调用的代码技能库
- 可能局限于当前任务的局部改进
- 依赖评价信号与 LLM 反思的质量
ExpeL
ExpeL 研究的是 LLM Agent 如何从过去经验中学习(experiential learning)
核心思想
将 Agent 的学习过程从
整体框架
Experience Gathering
Agent 在训练任务中不断尝试,经验池中保存:
- 成功轨迹(successful trajectories)
- 失败轨迹(failed trajectories)
其中失败经验主要通过 Reflexion 的方式产生反思
Insight Extraction(核心)
Reflexion:保存某一次失败后的反思
ExpeL:从大量经验中提取跨任务的抽象规律
避免经验具有任务特异性,形成通用策略
通过 ADD、EDIT、UPVOTE、DOWNVOTE 更新 insights;重要性计数降至零时移除对应 insight
Task Inference
面对新任务时,Agent 在当前任务信息的基础上
还会加入:
- 完整的 insights 列表
- 按任务相似度检索的 top-k successful trajectories
作为上下文增强决策
局限与我的思考
- 主要通过语言知识与轨迹示例提升决策能力,未构建可直接调用的代码技能库
- 依旧依赖 LLM 总结能力
- 已有 insight 更新与移除机制,但未研究可执行技能库的长期管理
Voyager
[2305.16291] Voyager: An Open-Ended Embodied Agent with Large Language Models
Voyager 研究的是开放世界中的 lifelong learning agent(终身学习智能体)
核心思想
以 Minecraft 为例,Agent 面对的不是一个固定任务,而应该在长期探索过程中不断学习,积累技能
三个主要问题:
- 下一步学什么;
- 如何复用已有的能力;
- 如何纠正学习过程中的错误;
让 Agent 在不更新模型参数的情况下,通过持续探索构建一个不断增长的外部能力库
整体框架
Voyager 主要包含三个核心模块:
1 | Voyager |
Automatic Curriculum
传统强化学习里,任务通常提前给定
Voyager 让大模型根据 Agent 当前状态,自己提出下一个任务
Skill Library(核心)
Voyager 学会一个任务之后,不只以文本描述成功的行为,同时保存为 Executable Code(可执行代码),以后需要这个能力的时候,就可以直接复用
整个过程可以理解成:
1 | 当前 Task |
已经开始有 Retrieval-based memory,而不是把所有 Skill 全部放进上下文
Iterative Prompting
Voyager 不依赖一次生成正确的行为,通过执行反馈驱动程序迭代优化
将:
- 环境反馈
- 执行错误
- 自验证结果
反馈给 LLM,用于下一轮代码修改
与 Reflexion 的区别:
- Reflexion:失败 → 语言反思 → 经验记忆
- Voyager:失败 → 程序修正 → 可复用技能
局限与我的思考
- 未系统研究 Skill 库的冗余、冲突与淘汰机制,规模扩大后的维护值得进一步研究
- Skill 检索能力有待改进,检索器本身不会随着经验增长而优化
- 泛化能力仍受环境限制,在 Minecraft 中环境反馈比较清晰
SkillWeaver
[2504.07079] SkillWeaver: Web Agents can Self-Improve by Discovering and Honing Skills
SkillWeaver 研究的是 让 Web Agent 在探索阶段无需人工提供待学习任务,通过自主探索网站发现和实践技能,并将经验沉淀为可复用 API
与 Voyager 同样积累可执行技能,进一步关注网页操作 API 的合成与测试打磨
核心思想
将交互轨迹抽象为结构化 API Skill,并通过实践、测试和 Debugging 提升 Skill 的可靠性
Skill 不再是简单文本经验,而是可复用的任务解决流程
代码载体是可复用 Python 函数,包含函数签名、docstring 和实现;概念上可归纳为:
- Skill Description
- 技能适用场景
- 输入条件
- 目标
- Skill Procedure
- 完成任务的操作步骤
整体框架
- Stage I:根据环境和已有 API 库发现新的 skill;
- Stage II:执行 Skill 产生 trajectory,并将成功轨迹合成为可复用 API;
- Stage III:通过测试和 debugging 提升 API 的可靠性
Stage I: Skill Proposal
使用 LLM 作为 automatic curriculum,让 Agent 根据网站环境提出新的探索目标
输入:
网站截图;
URL;
无障碍树;
本质是 DOM 的一个经过语义化处理的树,用于屏幕阅读器、自动化工具理解页面
当前已有 Skill Library
限制 Skill Proposal 主要关注
- 流程型任务
- 导航型任务
- 信息获取任务
Stage II: Skill Synthesis
将经验转化为技能的核心阶段
Agent 多次尝试执行任务,通过 LLM 充当的 Reward Model 判断任务是否完成
Reward Model 输入:
- 任务描述
- 行为轨迹
- 环境反馈
Agent 通过实践获得任务执行轨迹,由 Reward Model 根据任务描述、执行轨迹和环境反馈判断实践是否成功,再将成功轨迹抽象为可复用函数
Stage III: Skill Honing
SkillWeaver 相比 Voyager 更强调的部分
即使 trajectory 成功,也不能保证生成 API 完全可靠
对生成的 API 进行执行测试;需要额外参数时,由 LLM 生成测试参数,并根据执行反馈调试
Voyager 已有程序迭代与自验证,SkillWeaver 则显式设置了针对合成 API 的测试与调试阶段
Agent 不仅能够发现和生成 Skill,还能够通过实践、测试和 debugging 持续提升 Skill 的可靠性,并将其沉淀为可复用 API,推动 Skill Library 持续扩展。
局限与我的思考
- 生成的 API 通常依赖目标网站,同一 API 跨网站直接复用的范围仍有限
- Skill Proposal 的探索效率有限
- 成功执行 ≠ 最优技能
EvoSkill
[2603.02766] EvoSkill: Automated Skill Discovery for Multi-Agent Systems
EvoSkill 研究的是 如何让 Agent 自动发现和优化Skill,实现 Skill-level self-evolution
核心思想
现有 Agent 的能力扩展主要依赖人工设计 Skill,但人工构建 Skill 难以规模化
将 Skill 看作 Agent 的可进化模块
整体框架
EvoSkill 包含三个主要 Agent:
- Executor Agent:负责执行任务
- Proposer Agent:分析轨迹和输出,负责诊断,决定是创造新技能还是改进现有技能
- Skill-Builder Agent:负责Skill的构建
EvoSkill Loop
1 | flowchart TD |
每轮从程序池选择父程序,在训练任务批次上收集失败;有失败时提出技能改动并产生 candidate program
评分与筛选的对象是包含技能改动的 candidate program
候选在独立验证集上评测,frontier 未满时可加入,满员时须优于池中最低分程序才替换它,否则丢弃;不要求每次都超过父程序。
提案、得分与取舍结果均记入反馈历史,测试集仅用于最终评测
局限与我的思考
- 依赖 Failure Analysis 质量
- Evolution 成本高
- 可能存在搜索空间限制