大语言模型训练与推理
训练流程
通用文本大模型的主流预训练范式
1 | 大规模原始语料 |
Pretraining
预训练阶段主要使用大规模无标注文本,通过 Next Token Prediction 学习语言、知识和通用能力
对于序列:
Continued Pretraining,CPT:在已有 Base Model 上继续使用领域原始文本进行下一 Token 预测,主要改变模型的领域知识和语言分布适应能力,广义上也属于微调
Supervised Fine-tuning
使用高质量的 Instruction → Response 数据,让 Base Model 学习如何遵循指令并按照期望格式回答
Training Data通常是
1 | Instruction / User |
例如:
1 | User: |
多轮对话则类似:
1 | System: |
经过 Chat Template 和 Tokenizer 后,最终仍然变成一个 Token Sequence
本质上仍然是 Next Token Prediction
区别可以简单记为:
| 阶段 | 数据 | 主要目的 |
|---|---|---|
| Pre-training | 大规模普通文本 | 学习语言、知识和通用能力 |
| CPT | 特定领域普通文本 | 补充领域知识 |
| SFT | Instruction-Response | 学习如何完成用户指令 |
Preference Alignment
SFT 让模型学会“怎么回答”,Preference Alignment 进一步让模型学习“什么回答更好”
典型 Preference Dataset 包含
1 | Prompt |
RLHF
[2203.02155] Training language models to follow instructions with human feedback
基于人类反馈的强化学习,是 RL 在大模型对齐中的一种应用范式
经典流程:
1 | SFT Model |
需要根据偏好训练一个 Reward Model
然后 Reward Model 对回答输出一个标量奖励 $r_\phi(x,y)$
成对偏好训练常写为:
PPO
核心思想是:提高高优势动作的概率,同时限制新策略相对于旧策略一次更新过大
对于状态 $s_t $ 下采取的动作 $a_t$,定义新旧策略的概率比:
- $\theta$:当前策略模型的参数
- $a_t$:当前生成的 token
- $s_t$:Prompt + 前面已经生成的 token
但是 PPO 不希望策略一次更新得太激进,引入裁剪目标:
在 RLHF 中,Reward Model 对完整 Response 给出 Reward,再结合 Value Model 等方法估计每个 timestep 的 $\hat A_t$
核心是逐 token / 时间步优化
Reward Model + PPO 是经典的 RLHF 对齐方案
示例
1 | Prompt: |
1 | π_old: |
1 | Transformer: 0.48 / 0.40 = 1.20 |
假设每个时间步 Advantage
1 | A = [1.0, 0.5, 1.2, -0.2] |
1 | t1: ratio=1.20 × advantage=1.0 |
DPO
[2305.18290] Direct Preference Optimization: Your Language Model is Secretly a Reward Model
DPO 没有 PPO 那种 token-level 优化信号,直接利用
1 | Prompt |
优化模型对 Chosen 和 Rejected 的相对偏好
常见目标:
示例
1 | Prompt: |
假设当前模型 $\pi_\theta$ 对 chosen 的 token 概率是:
1 | Transformer 0.8 |
假设 rejected
1 | Transformer 0.7 |
然后 reference model 也分别计算
最后比较
GRPO
[2402.03300] DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
对于同一个问题,从旧策略采样一组回答:
Rule-based Reward :
- 答案正确:Reward = 1
- 答案错误:Reward = 0
根据同一 Prompt 下多个 Response 的组内 Reward 估计相对 Advantage
总结
| 对比项 | DPO | GRPO |
|---|---|---|
| 主要用途 | 通用偏好对齐 | 推理能力强化 |
| 典型场景 | 风格、语气、安全偏好 | 数学、代码、逻辑推理 |
| 训练数据 | Prompt + Chosen + Rejected |
Prompt + Group Response |
| Reward 来源 | Chosen / Rejected 偏好 | Rule-based Reward |
训练显存与数值精度
训练大模型时,显存主要由以下部分组成:
- Parameters:模型权重
- Gradients:反向传播产生的梯度
- Optimizer States:优化器保存的额外状态,例如 Adam 的一阶矩、二阶矩
- Activations:Forward 中保存、供 Backward 使用的中间结果
- Temporary Buffers:Attention、矩阵乘法等计算过程中的临时空间
数值精度
| 数据类型 | 位数 | Sign | Exponent | Mantissa | 每个元素显存 | 主要用途 |
|---|---|---|---|---|---|---|
| FP32 | 32 bit | 1 | 8 | 23 | 4 Byte | 高精度计算,显存占用大 |
| FP16 | 16 bit | 1 | 5 | 10 | 2 Byte | 混合精度训练 |
| BF16 | 16 bit | 1 | 8 | 7 | 2 Byte | 数值范围接近 FP32,当前大模型训练常用 |
| FP8 | 8 bit | 1 | 4/5 | 3/2 | 1 Byte | 低精度训练 |
| INT8 | 8 bit | -- | -- | -- | 1 Byte | 权重量化、推理 |
| INT4 | 4 bit | -- | -- | -- | 0.5 Byte | 低比特量化 |
如果考虑模型参数
- FP32:$7\times10^9\times4\approx28\text{ GB}$
- FP16 / BF16:$7\times10^9\times2\approx14\text{ GB}$
- INT8:$7\times10^9\times1\approx7\text{ GB}$
这些只是模型权重本身的显存,并不是完整训练显存
Mixed Precision
基本思想:使用 FP16 进行神经网络训练,在降低显存和计算开销的同时,尽量保持与 FP32 训练相同的精度
1 | FP16 |
FP32 Master Weights
Forward 和 Backward 使用 FP16 权重,但额外维护一份 FP32 Master Copy
1 | FP32 Master Weights |
原因是 FP16 精度有限,较小的 Weight Update 可能无法表示,甚至在更新时直接变成 0
使用 FP32 Master Weight 可以保留这些小更新
也就是存储使用FP32,但是计算用FP16
Loss Scaling
FP16 的动态范围比 FP32 小,较小的 Gradient 可能发生 Underflow
因此在 Backward 前将 Loss 乘一个 Scale
Unscale 将放大的 Gradient 除以 $S$ 恢复原始尺度
FP16 Multiply + FP32 Accumulation
对于矩阵乘法:
1 | FP16 × FP16 |
因为大量 FP16 数值直接累加容易产生较大的数值误差
分布式训练与并行
当单张 GPU 无法提供足够的计算能力或显存时,需要把训练拆到多张 GPU
核心可以分为两类
- 数据并行:模型复制,数据切分
- 模型并行:数据可以相同或分成 micro-batch,模型本身被切分
实际大模型训练通常会组合多种并行方式
| 并行方式 | 切分目标 |
|---|---|
| DP | Data |
| TP | Tensor |
| PP | Model Layers |
| EP | Experts |
| ZeRO / FSDP | Training States |
通信方式
AllGather
将各 GPU 上的 Shard 收集起来,使每张 GPU 都得到完整 Tensor
1 | GPU0: [A] |
AllToAll
常用于 Expert Parallel
每张 GPU 向其他 GPU 发送不同的数据块,用于数据重分布;各 GPU 通常同时持有本地 Token 和部分 Experts
Router 后通过 AllToAll 将不同 GPU 上的 Token 重新分发到对应 Expert 所在设备,计算完成后再通过一次 AllToAll 返回
1 | GPU0: [A0 → GPU0, A1 → GPU1] |
每个参与通信的 GPU 都既是发送方,也是接收方
ReduceScatter
AllReduce = 聚合后每张卡都有完整结果
ReduceScatter = 聚合后每张卡只保留一个 shard
数据维度
Data Parallel
每张 GPU 保存一份完整模型,但读取不同的数据
1 | GPU 0: batch 0 → gradient G0 ─┐ |
如果共有 $P$ 张 GPU:
PyTorch 中常用 DistributedDataParallel,DDP(这里是AllReduce )
DDP 的限制是:每张 GPU 都需要保存完整模型以及对应训练状态
因此模型本身必须能够放入单卡
ZeRO
[1910.02054] ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
Data Parallel 中,每张 GPU 都保存相同的:
1 | P:Parameters |
核心思想:将 Data Parallel 中冗余复制的训练状态分片存储
以下举例
1 | GPU 0: |
ZeRO-1
只分片 Optimizer States
1 | GPU 0:[完整参数] [完整梯度] [O0 O1] |
ZeRO-2
额外分片 Gradients
1 | GPU 0:[完整参数] [g0 g1] [O0 O1] |
使用 ReduceScatter聚合完成后直接拆开
ZeRO-3
把参数也分片
1 | GPU 0:[p0 p1] [g0 g1] [O0 O1] |
计算某一层之前,需要通过 AllGather 临时获取当前层所需参数(因为参数长期分片)
| 方法 | 主要分片内容 | 典型通信 |
|---|---|---|
| DDP | 不分片 | AllReduce 梯度 |
| ZeRO-1 | Optimizer State | ReduceScatter + AllGather 参数 |
| ZeRO-2 | Optimizer State + Gradient | ReduceScatter 梯度 + AllGather 参数 |
| ZeRO-3 | Optimizer + Gradient + Parameter | ReduceScatter 梯度 + 按需 AllGather 参数 |
FSDP
核心思想与 ZeRO-3 类似,将 Parameters、Gradients、Optimizer States 分片到不同 GPU,并在计算时按需 AllGather 参数
FSDP 是 PyTorch 原生提供的 Full Sharding 训练方案
核心行为基本就是:
1 | Parameters → Shard |
计算某一层前:
1 | Parameter Shards |
Backward 后:
1 | Gradients |
模型维度
Tensor Parallel
[1909.08053] Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
TP:将一个大的矩阵运算拆到多张 GPU
例如线性层,将权重矩阵按列切分:
- Attention Heads
- Q/K/V Projection
- MLP Linear Layers
进行 Tensor Parallel
TP 能解决单个 Layer 太大的问题,但会带来较频繁的 GPU 间通信
1 | Transformer Layer |
Pipeline Parallel
[1811.06965] GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism
PP:按照 Transformer Layer 切分模型
1 | GPU 0 GPU 1 GPU 2 GPU 3 |
简单流水线会产生 Pipeline Bubble
1 | 时间 0 1 2 3 4 5 6 7 |
大部分时间只有一张 GPU 在工作,设备利用率很低
因此通常把一个 Batch 切分为多个 Micro-batch:
1 | 时间 0 1 2 3 4 5 6 7 8 9 10 11 12 13 |
若有 $K$ 个 pipeline stages,$M$ 个batch,简单情况下设备利用率大致为:
但 Micro-batch 过多会增加调度、通信开销
Expert Parallel
MoE 中通常存在大量 Experts,但每个 Token 只激活少量专家
EP:将不同专家放到不同 GPU
1 | GPU 0: Expert 0, 1 |
Router 根据 Token 决定目标 Expert 后,需要把 Token 发送到对应 GPU
1 | Token |
因此,MoE 可以降低单 Token 的激活参数量,但性能通常受 通信开销 和 Expert 负载均衡 影响
Hybrid Parallelism
1 | Hybrid Parallelism |
DP + TP + PP:Dense LLM 很经典的一种组合
DP + TP + PP + EP:MoE模型
总 GPU 数通常可表示为:
参数高效微调
LoRA
[2106.09685] LoRA: Low-Rank Adaptation of Large Language Models
LoRA:Low-Rank Adaptation
传统 Full Fine-tuning 需要更新模型全部参数,随着模型规模增大,会带来较高的训练、显存和模型存储成本
LoRA 的核心假设:大模型适配下游任务时,权重更新具有较低的 intrinsic rank,因此不需要学习完整的参数更新矩阵。
对于预训练权重:
其中:
训练时冻结预训练参数 $W_0$,只更新低秩矩阵 $A$ 和 $B$,前向传播变为:
论文实验表明,在部分模型和任务中,即使使用很小的 rank,例如 $r=1$、$r=2$ 或 $r=4$,也可以获得较好的效果
Parameter Reduction
对一个 $d\times k$ 的权重矩阵
Full Fine-tuning 训练参数量为 $dk$
LoRA 只需要训练 $A$ 和 $B$,参数量为:
LoRA:$4096 \times 8 + 8 \times 4096 = 65,536$
仅约为原参数量的:$\frac{65,536}{16,777,216}\times 100% \approx 0.39%$
Initialization
LoRA 使用:
Scaling
实际前向传播中,LoRA 会对低秩更新加入缩放系数
Applying to Transformer
LoRA 原理上可以应用于任意 Dense / Linear Layer
Transformer Self-Attention 中主要包含:
在大多数实验中将 LoRA 应用于 $W_q$ 和 $W_v$
Merge at Inference
训练完成后,可以将 LoRA 更新直接合并进原始权重
Practical Issues
LoRA 能显著减少可训练参数量,但实际使用中仍存在几个需要重点关注的问题
Rank $r$ 的选择
$r$ 决定了 LoRA 分支的表达能力
- $r$ 太小:参数更新空间受限,可能无法充分适配下游任务,出现欠拟合;
- $r$ 太大:会增加可训练参数和显存占用,也可能增加过拟合风险。
本质上是在调参效率和适配能力之间进行权衡
Target Modules 的选择
LoRA 可以应用到 Transformer 中不同的线性层,也可以应用到 MLP 中的 Linear Layer
不同任务需要调整的参数方向不同,因此 LoRA 插入的位置会直接影响效果
Target Modules 本身也是 LoRA 的重要超参数
训练显存
LoRA 主要减少可训练参数和优化器状态,前向传播仍然需要经过完整模型,因此模型权重和中间 Activation 仍然会占用大量显存
对于大模型训练,通常还需要结合
- Mixed Precision
- Gradient Checkpointing
- Quantization
进一步降低显存占用
QLoRA
QLoRA:Quantized Low-Rank Adaptation
QLoRA 在 LoRA 基础上进一步将预训练模型量化为 4-bit,冻结量化后的 Base Model,只训练 LoRA Adapter。
Quantization
量化就是把高精度数据表示成更低 bit 的数据
以 FP32 → Int8 为例
而后做一个线性映射到 Int8 的范围,于是就得到上式
1 | FP32: -2 -1 0 1 2 |
FP32 中,两个很接近的数可以被区分,但Int8 只有有限的整数
所以原来连续范围里的很多 FP32 数值,都会被映射到同一个 Int8 整数
那么 Int8 相邻两个量化等级对应的 FP32 间隔,也就是 quantization step
一个数最多偏离最近量化点半个 step
NF4
4-bit NormalFloat,NF4
预训练神经网络权重通常近似 zero-centered normal distribution(零中心正态分布)
因此不是简单地把数值范围均匀划成 16 个区间,而是根据正态分布的 quantile 设计 4-bit 表示,使每个量化区间预期包含相近数量的权重值
论文实验中,NF4 的量化精度优于 FP4 和 Int4
Double Quantization
量化之后并不是只有 4-bit Weight
还需要保存每个 block 对应的 Quantization Scale
1 | Block 1 → scale c₁ |
假设 block = 64,那么每个 block 需要 32 bit
平均到每个模型参数上
QLoRA 提出继续量化第一次量化产生的量化常数
1 | Weights |
把这些 scale 量化成 8 bit,假设第二级 block size 为 256
1 | 4-bit weights |
但主要贡献还是来自于 Base Model 和训练过程中的 activations
为了尽量恢复 16-bit 微调效果,在 Transformer Block 的所有 Linear Layers 上加入 LoRA 很重要
Paged Optimizer
训练过程中某些长序列或 Gradient Checkpointing 场景可能突然产生显存峰值
Paged Optimizer 使用 NVIDIA Unified Memory
当 GPU 显存不足时:
1 | GPU |
Optimizer State 可以暂时 page 到 CPU RAM,之后再移回 GPU,从而避免偶发的 OOM
LLM 推理
LLM 推理的核心特点是 Autoregressive Generation
1 | Prompt |
KV Cache
如果不使用 KV Cache,每生成一个新 Token,都需要重新计算历史 Token 的 $K,V$
因此缓存:
- Transformer 层数为 $L$
- Context Length 为 $T$
- KV Head 数为 $H_{KV}$
- Head Dimension 为 $d_h$
- 每个元素占 $b$ Bytes
单条 Sequence 的 KV Cache 约为:
因此长上下文、大 Batch 下,KV Cache 会成为推理显存的重要瓶颈
FlashAttention
[2205.14135] FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
标准 Self-Attention 的时间和显存开销会随序列长度 $N$ 呈平方增长,很多已有方法只关注减少 FLOPs,却忽略了 GPU 中真正影响 wall-clock time 的 memory access
FlashAttention 因此提出 IO-aware Attention
Standard Attention
标准 Attention:
1 | 从 HBM 读取 Q、K |
标准实现会把 $S$ 和 $P$ 以及注意力矩阵反复在 HBM 和片上存储之间搬运
GPU Memory Hierarchy
| 存储 | 位置 | 容量 | 速度 / 带宽 | 延迟 | 存储对象 |
|---|---|---|---|---|---|
| CPU DRAM | 电脑内存 | 几十到几百GB | 最慢 | 最高 | 未放入 GPU 的模型/数据 |
| GPU HBM | GPU 显存 | 几十GB | 很快 | 中等 | Model Weights、Activations KV Cache、Gradient |
| GPU SRAM | GPU 芯片内部 | KB~MB 级 | 非常快 | 很低 | 正在计算的小块数据、中间结果 |
FlashAttention 的核心问题:怎么尽可能把计算留在 SRAM 里完成,减少访问 HBM
Tiling
把 $Q,K,V$ 划分成多个小 block,每次只把一小块从 HBM 加载进 SRAM
就不会在 HBM 中构造完整的 Attention Matrix
Softmax分块
普通 Softmax
FlashAttention 使用可增量更新的 Softmax 统计量
- $m$:当前最大值
- $l$:当前指数和
- $u$:输出累积向量
就可以一个 block 一个 block 地计算 Softmax,而不需要一次把整行元素全部放进 SRAM
因为 Softmax 的基准最大值发生改变,旧统计量需要重新缩放:
Recomputation
标准 Attention 为了 backward,需要保存 $S, P$ 和 注意力矩阵
FlashAttention 不保存它们,所以需要通过保存的 $O, m, \ell$ 重新计算来获得梯度
用额外计算换取更少 HBM 访问和更少显存
虽然 FLOPs 增加了,但由于减少了 HBM IO,实际反而更快
vLLM
[2309.06180] Efficient Memory Management for Large Language Model Serving with PagedAttention
vLLM 是一个面向大语言模型的 LLM Serving Engine
LLM 推理过程中,KV Cache 占用大量 GPU 显存,并且会随着生成长度动态增长。
传统连续显存分配方式通常需要提前预留较大的 KV Cache 空间,同时要求显存连续,容易产生显存浪费和碎片,从而限制 Batch Size 和 Serving Throughput。
KV Cache
LLM 使用 Autoregressive Generation
因此将之前已经计算过的 $K,V$ 缓存下来:
PagedAttention
传统 LLM Serving 通常为每个 Request 分配连续的 KV Cache 空间,并可能按照较大的最大 Sequence Length 提前预留显存
PagedAttention 借鉴操作系统中的 Virtual Memory / Paging
将一个 Request 的 KV Cache 划分为多个固定大小的 KV Block,而不再要求 KV Cache 在物理显存中连续存储
逻辑上:
1 | Request A |
在 GPU 显存中可以实际存储为:
1 | Logical Block 0 → Physical Block 7 |
通过 Block Table 保存 Logical Block 到 Physical Block 的映射关系
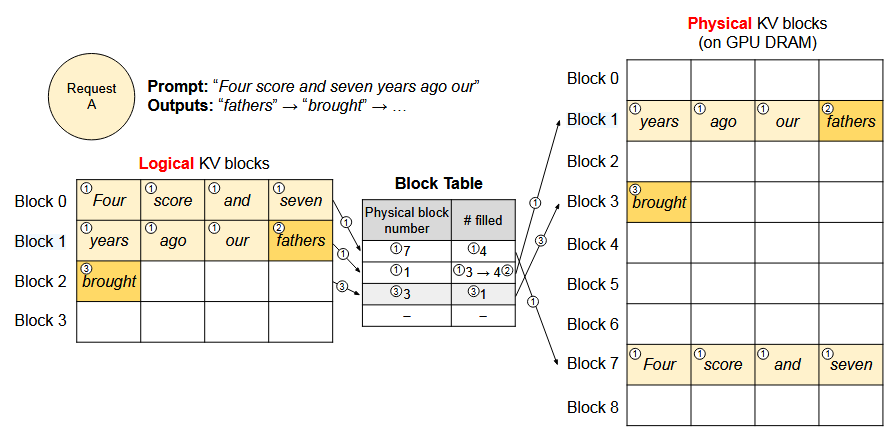
1 | token 的逻辑位置 |
因此一个 Sequence 的 KV Cache 可以分散存储在不连续的 Physical Blocks 中,从而利用零散的空闲显存
Dynamic Allocation
vLLM 不需要提前按照最大 Sequence Length 分配完整 KV Cache,而是随着 token 生成按需分配新的 Physical KV Block
例如一个 Block 存 4 个 token
1 | token 1 2 3 4 |
当前 Block 被填满后,如果继续生成 token 9,才申请新的 Block 2
1 | 需要多少 KV Cache |
因此通常只有最后一个未填满的 Block 会产生少量碎片。
KV Cache Sharing
PagedAttention 还支持多个 Sequence 共享相同的 Physical KV Block
例如多个输出拥有相同 Prompt 时,Prompt 对应的 KV Cache 可以只保存一份
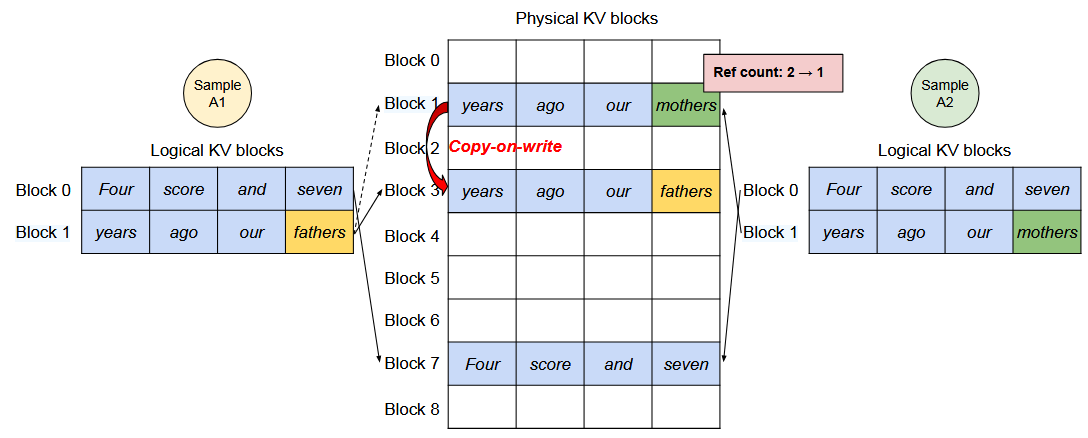
当某个 Sequence 需要修改共享 Block 时,vLLM 使用 Copy-on-Write
这样可以进一步减少重复 KV Cache 的显存占用