视觉表征、生成与多模态模型演进
视觉表征
VIT
[2010.11929] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
核心思想:将图像划分为多个固定大小的 Patch,把每个 Patch 看作 NLP 中的一个 Token,通过 线性映射为固定维度的 Patch Embedding,再直接输入标准 Transformer Encoder
传统 CNN:
1 | Image |
ViT
1 | Image |
将二维图像转化成一维 Patch Token Sequence,把图像识别转化为序列建模问题
Patch Embedding
给定输入图像
Patch 数量:
Position Embedding
ViT 在 Patch Embedding 上加入 Position Embedding
原始 ViT 延续 BERT 的设计,在 Patch Token 前加入一个可学习的 [CLS] Token
默认使用可学习的一维位置编码
序列中的每个位置都有一个独立的、可学习的 $D$ 维位置向量
经过多层 Self-Attention 后,[CLS] Token 可以与所有 Patch Token 进行信息交互,最终其输出作为整张图像的表示,用于分类
ViT-B/16 完整流程
1 | Input Image |
现代 VIT
CLS Token 只是获得全局图像表示的一种方式,并不是 Transformer 的必要组成部分
一些后续视觉 Transformer 会直接对 Patch Tokens 进行 Global Average Pooling:
- 不需要额外学习 CLS token
- 训练更加稳定
- 与 CNN 的 Global Average Pooling 类似
局限
虽然 ViT 将 Transformer 引入视觉领域,但存在两个问题:
- Self-Attention 计算量高,随着图像分辨率提高,计算和显存开销增长很快
- 缺少 CNN 的层次化结构
因此后续提出Swin Transformer:通过窗口注意力和层次化结构,让 Transformer 更适合视觉任务
Swin Transformer
[2103.14030] Swin Transformer: Hierarchical Vision Transformer using Shifted Windows
核心思想:通过三个核心设计解决VIT的问题
- Window Attention:降低 Self-Attention 计算量
- Shifted Window:实现不同 Window 之间的信息交互
- Patch Merging:建立层次化信息结构
Patch Embedding
输入图像
1 | Input |
每个 $4\times4\times3$ 的 Patch 被展平成一个长度为 48 的向量
ViT 强调全局的一维 Token sequence;Swin 则保留 Patch 的二维网格结构
Window Partition
Swin 不进行全局 Attention,而是划分局部窗口
1 | [B, 56, 56, 96] |
每张图有 64 个 window,每个 window 有 49 个 token,每个 token 是 96 维
把 Window 合并进 Batch 后就可以把每个 window 当成一个独立的小序列做 Self-Attention
W-MSA
W-MSA:Window Multi-head Self-Attention
1 | ┌───────┬───────┐ |
每个 Window 内部进行 Self-Attention,不同窗口之间不发生交互,使得计算量显著下降 ($O(M^2N)$),也因此需要 Shifted Window
SW-MSA
SW-MSA:Shifted Window Multi-head Self-Attention
下一层不继续使用相同窗口,而是将 Window Partition 平移,移动大小为 $\left\lfloor M/2\right\rfloor$
1 | 原窗口 |
实现跨 Window 信息交流
Swin Block
W-MSA 负责窗口内部建模,SW-MSA 负责跨窗口信息传播
连续两个 Block 分别使用 W-MSA 和 SW-MSA
1 | Swin Block L |
相对位置偏置
Swin 的 Attention 中加入了相对位置偏置 (Relative Position Bias)
Attention 可以写成:
对于视觉空间,这种相对关系非常自然
Patch Merging
ViT 基本保持同一尺度,而 Swin 逐渐降低空间尺寸,同时提升 channel
会在 Swin Block 后下采,下采采用拼接 + Linear 的实现方式
1 | 特征图 |
产生了 CNN 模式的特征金字塔
| ViT | Swin | |
|---|---|---|
| Token形式 | 一维序列 | 二维Feature Map |
| Attention | Global Attention | Window Attention |
| 复杂度 | $O(N^2)$ | $O(NM^2)$ |
| 空间结构 | 弱 | 强 |
| 多尺度 | 无 | 有 |
| Patch数量 | 固定 | 逐层减少 |
| 适合任务 | 分类 | 分类/检测/分割 |
ConvNeXt
核心思想:以经典 ResNet 为基础,引入 Transformer 时代的设计思想,对传统 ConvNet 进行现代化改造,使纯 CNN 达到与 Swin Transformer 相近的性能
与 ResNeXt 没有直接继承关系:
- ResNeXt:通过 Cardinality(多分支)增强 ResNet
- ConvNeXt:重新设计 CNN Block,使其适应现代训练方式
Depthwise Convolution
传统卷积同时完成:
- Spatial Mixing:融合邻域空间信息
- Channel Mixing:融合不同通道的信息
ConvNeXt 将两种操作显式拆开
- Depthwise Conv:每个 Channel 独立进行空间卷积,Channel 之间不发生信息融合
- 1 × 1 Conv:进行 Channel 之间的信息融合
从参数量上来看:
普通卷积
$$ Params=K^2C_{in}C_{out} $$Group Conv (分组 $G = Cardinality$)
$$ \mathrm{Params}=\frac{K^2C_{in}C_{out}}{G} $$Depthwise Conv 可以看作 $G=C_{\text{in}}$,并且通常 $C_{\text{out}}=C_{\text{in}}$
$$ Params=K^2C_{in} $$
相比普通卷积,Depthwise Conv 可以用较少的参数和计算量完成 Spatial Mixing
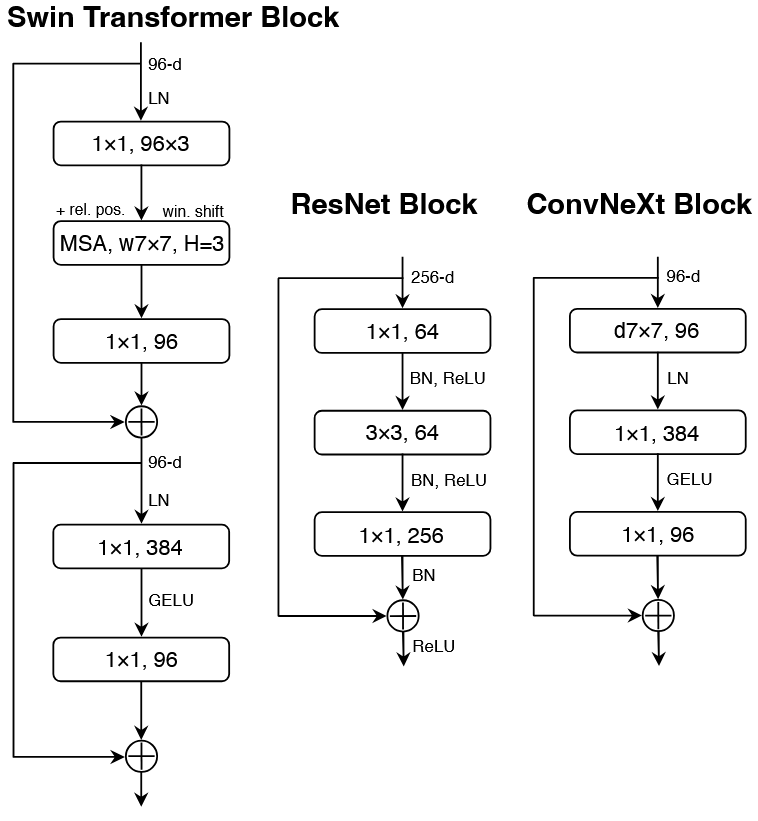
传统 ResNet Block 主要使用 $3\times3$ Conv,而 ConvNeXt 采用 $7\times7$ Depthwise Conv
使用更大的卷积核,以较低额外计算成本扩大空间感受野
Inverted Bottleneck
传统 ResNet Bottleneck
1 | Input C |
先降维 → Spatial Mixing → 再升维
ConvNeXt 在 Channel Mixing 部分采用类似 Transformer FFN 的 Inverted Bottleneck:
1 | Input C |
先升维 → 非线性变换 → 再降维
类比Transformer:
- $7\times7$ Depthwise Conv:负责 Spatial Mixing
- $1\times1$ Conv / Linear:构成类似 FFN 的 Channel Mixing
ConvNeXt-T Architecture
和 Swin 基本一致
| Stage | Feature Size | Channel | Block数量 |
|---|---|---|---|
| Stage 1 | 56×56 | 96 | 3 |
| Stage 2 | 28×28 | 192 | 3 |
| Stage 3 | 14×14 | 384 | 9 |
| Stage 4 | 7×7 | 768 | 3 |
视觉 Tokenizer
最基础的 Autoencoder (自编码器,AE) 可以写成
- $x$ :输入图像
- $z$:潜在表示(Latent Representation)
- $\hat{x}$:重建得到的图像
训练目标是使重建结果尽可能接近原始输入
VAE
Variational Autoencoder 变分自编码器
核心:与普通 Autoencoder 把输入编码为一个确定的 latent vector 不同,将输入编码为一个潜变量概率分布
1 | x |
经过 Encoder 后得到一组分布参数,从该分布中采样
VAE 的训练不仅要求 Decoder 能够重建输入,还会约束潜变量分布
- Reconstruction Loss:保证 $z$ 中保留足够的信息来重建输入
- KL 散度:约束使不同样本的潜在分布整体接近 $\mathcal N(0,I)$
最终得到一个连续且较规整的 Latent Space
VQ-VAE
Vector Quantized Variational AutoEncoder 向量量化变分自编码器
核心:将 Encoder 得到的连续特征通过 Vector Quantization(向量量化) 映射到有限 Codebook 中,从而得到离散的潜在表示(Discrete Latent Representation)
1 | x |
Vector Quantization
VQ-VAE 维护一个可以学习的 embedding table
- $K$:离散 latent space 的大小,也就是 Codebook Size
- $D$:每个 embedding vector 的维度
对于 Encoder 输出的每一个向量 $z_e(x)$,在 Codebook 中寻找距离最近的 embedding
1 | Token ID |
而 VQ-VAE 在编码阶段相当于反过来
1 | Encoder Feature |
模型自己学习了一套离散表示,使得连续空间变成了有限的离散状态
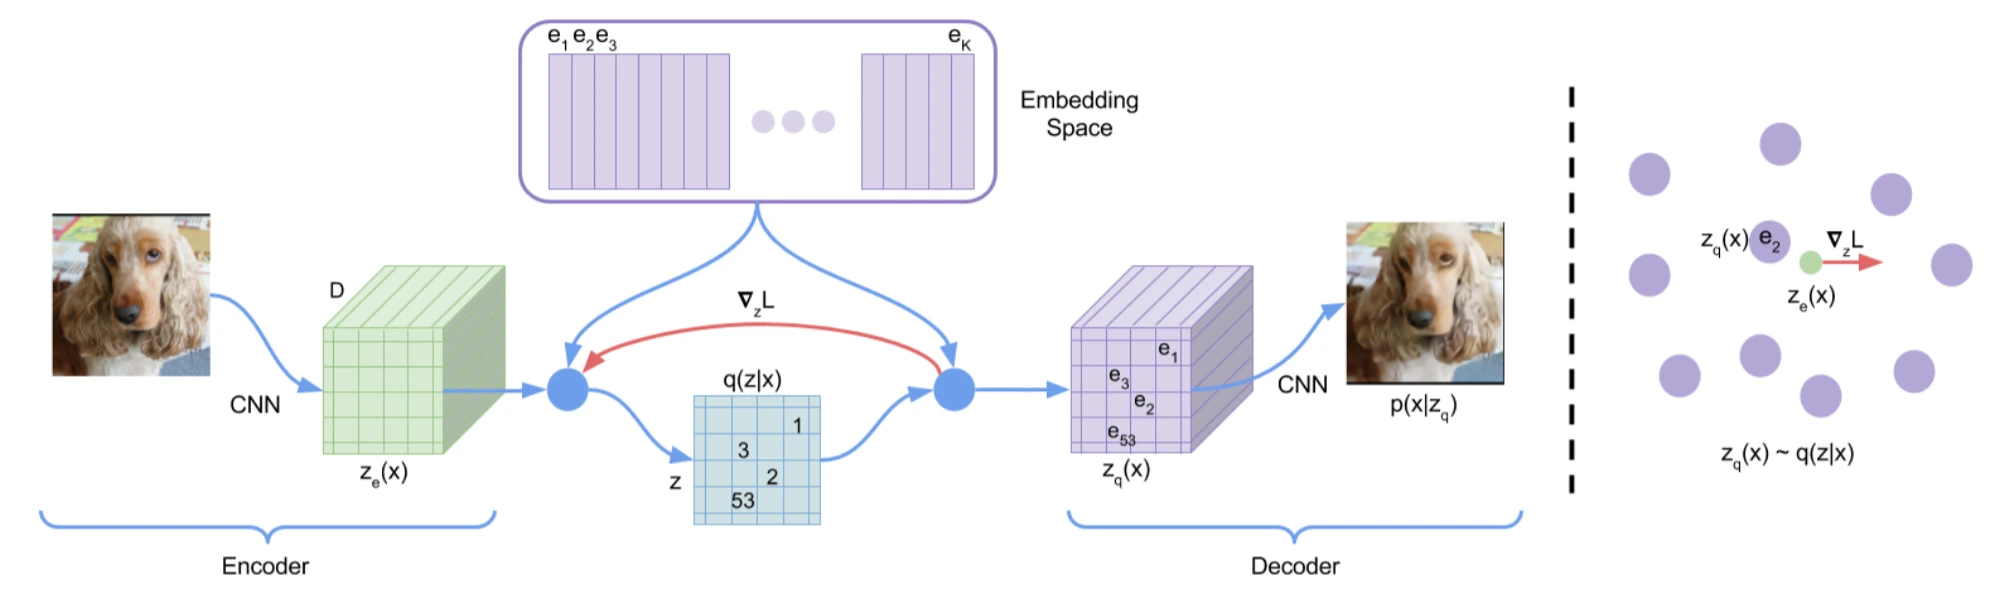
1 | Image |
Train
问题:Quantization 使用 argmin ,没有真正的梯度,所以无法正常反向传播
使用 Straight-Through Estimator,STE (直通估计器)的方法:
- Forward :使用量化后的 $z_q (x) = e_k$
- Backward :把 Decoder 输入 $z_q(x)$ 的梯度复制给 Encoder 输出 $z_e(x)$
把 Quantization 在反向传播时近似当作 Identity
在Pytorch中:
1 | z_q = z_e + (e_k - z_e).detach() |
利用 .detach() 切断梯度,且前向传播中 $z_q = e_k$
反向传播时相当于 z_q = z_e + 常数
Loss
VQ-VAE 的训练目标包含三个部分:
常见的就是MSE
目标是让 Codebook 中被选中的 embedding 向 Encoder 输出靠近
Commitment Loss
Encoder 去追 Codebook Embedding
训练目标
| Loss | Encoder | Codebook | Decoder |
|---|---|---|---|
| Reconstruction Loss | ✓ | × | ✓ |
| Codebook Loss | × | ✓ | × |
| Commitment Loss | ✓ | × | × |
- Encoder 学习如何把输入映射到有用的离散表示
- Codebook 学习 embedding space
- Decoder 学习如何根据量化后的 latent 重建输入
相比VAE,无需KL散度,因为潜空间不再连续
Prior
前面训练解决的是给定图片,如何得到离散 latent
但生成时并没有输入 $x$ ,因此还需要学习离散 latent 的概率分布 $p(z)$
VQ-VAE 采用 Two-Stage 的训练方式
1 | Stage 1 |
feature map 中不同位置的 latent 并不是独立的,因此可以使用自回归模型学习
论文中:
- 图像使用 PixelCNN
- Raw Audio 使用 WaveNet
在生成阶段其实就用不到Encoder了
VQGAN
[2012.09841] Taming Transformers for High-Resolution Image Synthesis
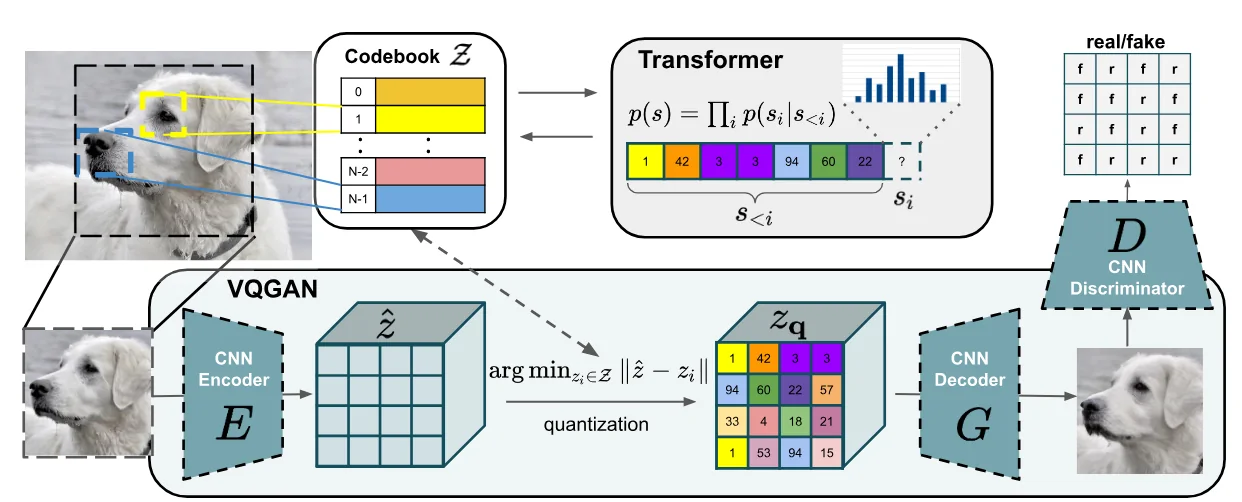
核心:先使用 VQGAN 将图像压缩成由有限 Codebook 构成的离散视觉表示,再使用 Transformer 建模这些离散视觉 Token 的组合关系
Loss
继承 VQ-VAE 的量化训练方式
VQ-VAE 的 Reconstruction Loss 更关注像素级重建,但如果压缩率进一步提高,仅使用 Pixel-level Reconstruction Loss 容易导致图像纹理和细节的感知质量下降
将原本的 $L_2$ Reconstruction Loss 替换成 Perceptual Loss(感知损失)
额外引入一个 Patch 二分类判别器 $D$,关注图像局部 Patch 的真实性
希望真实图 $D(x)$ 接近1,重建图 $D(\hat x)$ 接近0
最后完整目标:
VQGAN:Perceptual Loss + Patch-based GAN → 允许更强压缩
Prior
VQGAN 仍然采用和 VQ-VAE 类似的 Two-Stage 思路
但第二阶段不再使用 PixelCNN 建模离散 latent,而是使用 Transformer
扩散模型
U-Net
[1505.04597] U-Net: Convolutional Networks for Biomedical Image Segmentation
U-Net 是一种用于图像分割的 Encoder-Decoder 结构
论文将网络分为:
- Contracting Path:收缩路径,对应 Encoder
- Expansive Path:扩张路径,对应 Decoder
核心思想:收缩路径用于捕获上下文信息,扩张路径则用于恢复空间分辨率,从而实现精确的定位
整体结构:
1 | Input |
Encoder 和 Decoder 对应层之间通过 Skip Connection 连接
Encoder
逐渐降低空间分辨率,同时提取更高层的语义和上下文特征
1 | 3×3 Conv |
Decoder
将低分辨率的高级语义特征逐步恢复到高分辨率,并完成精确定位
1 | Upsampling |
Skip Connection
如果只使用普通 Encoder-Decoder
在不断下采样过程中,精确的位置信息可能逐渐丢失
因此 U-Net 把 Encoder 中的高分辨率特征直接送给 Decoder
沿着 Channel 维拼接后通过 Conv 融合这些特征
输出
原始 U-Net 用于图像分割
1 | Feature Map |
将每一个像素位置上的特性向量映射到目标类别数
DDPM
DDPM 包含两个方向相反的 Markov Process
1 | Forward Process |
其中:
- Forward Process:人为定义的逐步加噪过程
- Reverse Process:由神经网络学习,从 Gaussian Noise 逐步恢复数据
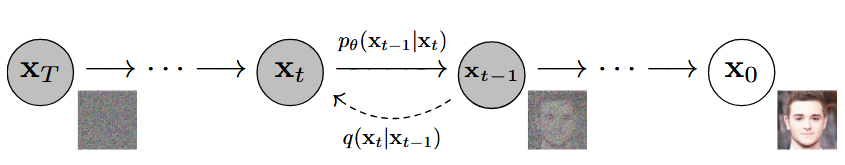
Forward Process
每一步向数据加入少量 Gaussian Noise
- $q$:人为定义的 Forward Process
- $\beta$:第 $t$ 步加入噪声的 variance schedule
定义:
训练阶段知道原始数据 $x_0$,因此 Forward Process 的一步反向可以解析求出,并且仍然是 Gaussian:
Reverse Process
逆过程希望学习:
- 均值:$\mu_\theta(x_t,t)$
- 协方差:$\sum_\theta(x_t,t)$
但在论文里直接规定
Loss
在 variance 固定之后,对应的 KL term 可以写成:
通过将 mean 重新参数化为:
| 符号 | 来源 | 含义 |
|---|---|---|
| $\varepsilon$ | Forward Process | 真正加到 $x_0$ 上的 Gaussian noise |
| $\varepsilon_\theta(x_t,t)$ | U-Net | 网络预测出来的噪声 |
因此可以直接训练
Timestep
不同的 $t $ 对应不同的 Noise Level,但所有 timestep 共用同一个 U-Net 参数
因此网络不仅需要输入 $x_t$ 还需要知道 $t$
用 Transformer 的位置编码方式来编码 timestep
LDM
[2112.10752] High-Resolution Image Synthesis with Latent Diffusion Models
Latent Diffusion Model,潜空间扩散模型
Pixel-space Diffusion Model 直接在高维 RGB 图像上进行反复去噪,训练和采样都需要大量计算
核心思想:使用 Autoencoder 将图像压缩到一个低维、感知上近似等价的 Latent Space,再在 Latent Space 中训练 Diffusion Model
感知压缩
目的是去掉高频、感知上不重要的信息,同时尽量保留图像的语义和视觉细节
训练一个 Autoencoder:
LDM 的第一阶段与 VQGAN 的 Perceptual Compression 思想非常接近
Latent Diffusion
训练好 Encoder $E$ 和 Decoder $D$ 后,将它们固定
不再对 Pixel $x$ 做 Diffusion,而是在 Latent $z$ 中执行
1 | z₀ → z₁ → z₂ → ... → z_T |
与 DDPM 完全相同,可以写成
- DDPM:预测 Pixel Space 中的噪声
- LDM:预测 Latent Space 中的噪声
LDM 的 Diffusion Backbone 仍然采用 Time-Conditional U-Net
DiT
核心:用 Transformer 替换 Diffusion Model 中传统的 U-Net Backbone
Latent Diffusion
DiT 并不是直接在高分辨率 Pixel Space 上运行 Transformer,而是建立在 LDM 框架之上
先使用预训练 Autoencoder
1 | Image |
整个 Diffusion Process 都发生在这个 Latent Space
可以理解为:
- LDM:Latent Diffusion + U-Net
- DiT:Latent Diffusion + Transformer
Diffusion 数学过程基本没有发生变化
Patchify
Latent $z_t$ 仍然是二维 Feature Map:
Transformer 不能直接按照二维 Feature Map 的形式处理,所以与 ViT 类似,DiT 首先对 Latent 进行 Patchify
假设 Patch Size 为
对于位于二维网格坐标 $(x,y)$ 的 Patch,分别对 $x$ 和纵坐标 $y$ 使用不同频率的 sine / cosine 函数进行编码
单个坐标的位置编码形式与 sinusoidal positional encoding 类似
DiT Block
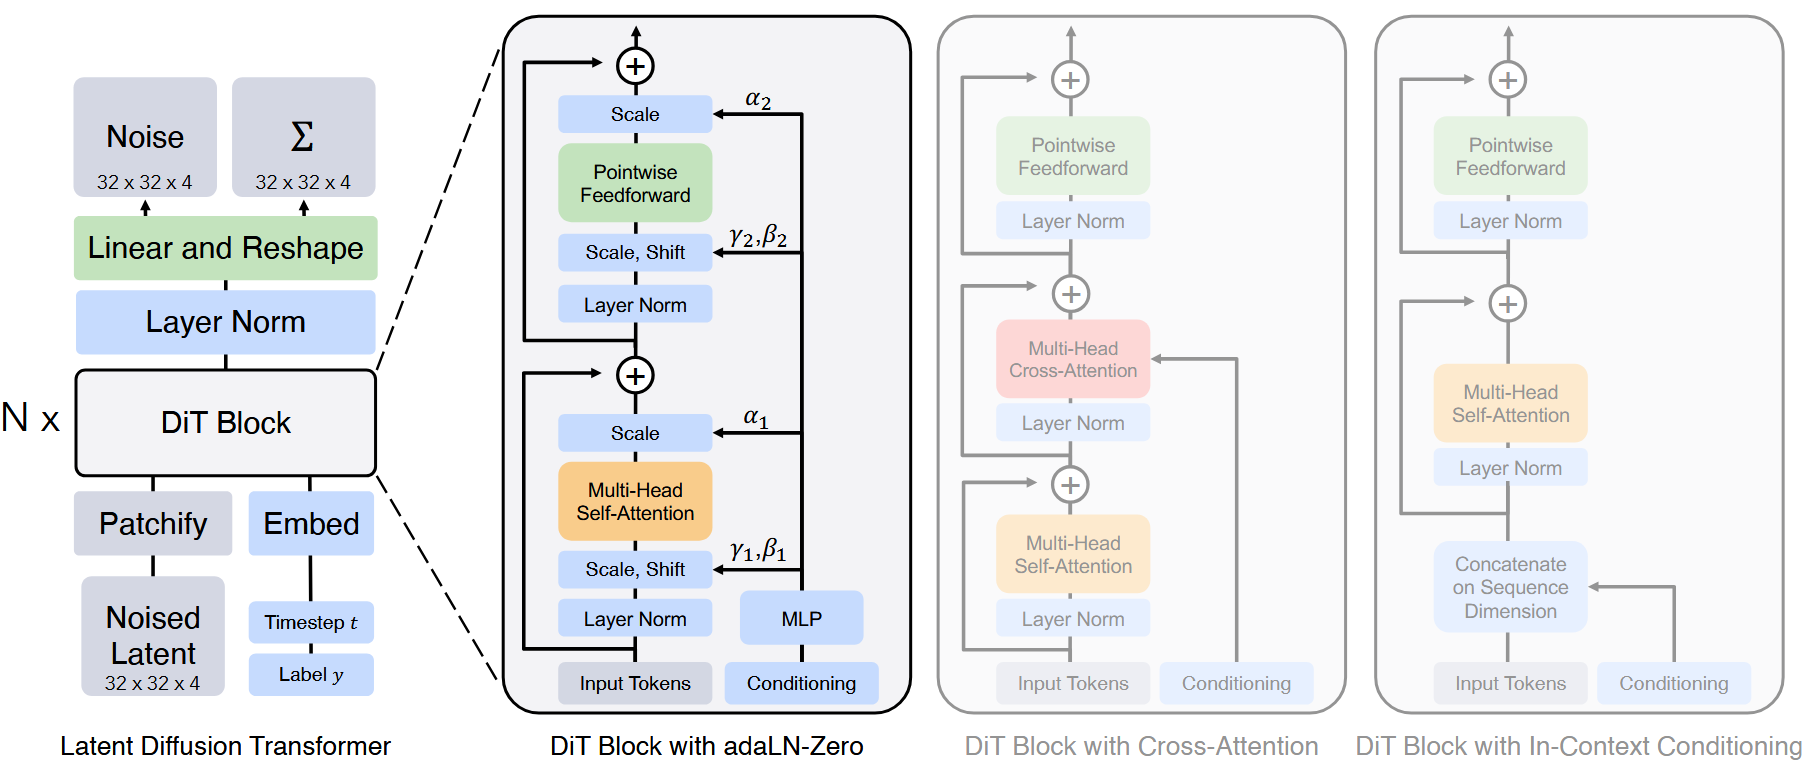
基本结构是标准 Transformer,所以 DiT 没有 U-Net 的 Downsample → Bottleneck → Upsample,尺寸始终保持一致
Diffusion Model 除了输入 Noisy Latent 还需要知道
- timestep $t$
- class label $y$
论文比较了多种方法
1 | Condition |
In-Context Conditioning
分别得到:
1 | Image Tokens: |
最后一个 Transformer Block 后,再把Condition Tokens 删除
Cross-Attention
在 Self-Attention 后加入一个 Cross-Attention Layer
1 | Image Tokens |
这种方式与 LDM 中的思路比较类似
但是额外的 Cross-Attention 会增加计算量
adaLN
Adaptive Layer Normalization
不把 $t$、$y$ 当作普通 token,而是利用它们去控制 LayerNorm
相比 Cross-Attention,adaLN 引入的额外 Gflops(十亿次浮点运算) 最少
adaLN-Zero
论文使用的不是普通 adaLN
在 adaLN 的基础上继续加入一个可学习的 Scale
初始化时:
借鉴了 ResNet 和 Diffusion U-Net 中将 Residual Branch 初始化为零的思想,这种设计有利于深层网络训练
后续工作基本全部采用 adaLN-Zero
多模态
CLIP
[2103.00020] Learning Transferable Visual Models From Natural Language Supervision
CLIP:Contrastive Language-Image Pre-training
传统视觉分类模型通常学习:
1 | Image |
这类方法通常需要预先定义固定类别,并依赖人工标注的分类数据
核心思想:使用自然语言作为视觉监督信号,同时训练 Image Encoder 和 Text Encoder,将图像和文本映射到同一个多模态向量空间,通过对比学习使匹配的图文表示靠近、不匹配的图文表示远离,解决图像与文本如何进行语义对齐的问题
模型结构
CLIP 由两个 Encoder 构成:
1 | CLIP |
对比学习
训练数据由大量匹配的 (image, text) Pair 构成
一个 Batch 中
分别提取视觉和文本 Feature,进行 L2 归一化,两个 Embedding 的 Dot Product 就等价于 Cosine Similarity
训练目标就是让对角线相似度更高,非对角线相似度更低
对比损失
Similarity 在进入 Softmax 前还会经过缩放
训练时同时优化两个方向:
Image → Text
给定一张图片 $I_i$,在 batch 中所有文本里找到与它匹配的 $T_i$:
Text → Image
给定文本 $ T_i$,在所有图片中找到 $ I_i$:
最终
CLIP 同时优化,形成一个对称的 Contrastive Objective
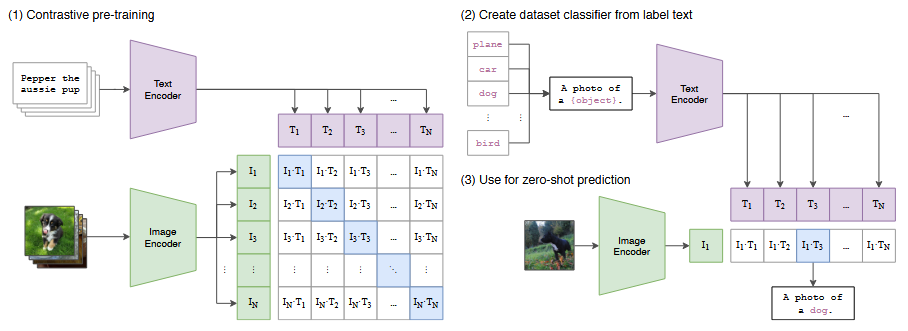
Zero-shot 分类
CLIP 最重要的能力之一是:下游分类时不需要重新训练一个固定的 Linear Classifier,而是直接使用自然语言描述目标类别
假设一个数据集包含:
1 | dog |
传统分类器:
1 | Image Feature |
而 CLIP 可以直接构造:
1 | "a photo of a dog." |
分别经过 Text Encoder
1 | Text Prompt |
这些 Text Embedding 就可以看成 Classification Weight
Text Encoder 可以理解为根据自然语言动态生成 Linear Classifier 的权重
Prompt Engineering
如果直接将 dog 输入 Text Encoder,效果并不是最好
因为 CLIP 预训练时遇到的文本通常是自然语言描述,而不是孤立的类别名称
因此论文使用:
1 | "A photo of a {label}." |
作为一个效果较好的默认模板
Prompt 实际上是在利用自然语言更加准确地定义视觉类别
CLIP 与 LLM
Zero-shot:
两者共同的范式可以理解为:通过大规模预训练获得通用能力,在下游任务中通过自然语言指定任务,而不重新训练模型参数
| CLIP | LLM | |
|---|---|---|
| 输入 | Image + Text | Text |
| 预训练任务 | Image-Text Contrastive Learning | Next Token Prediction |
| 核心能力 | Visual-Language Alignment | Language Modeling |
| Zero-shot | Prompt 定义 Classification Class | Prompt 描述 Task |
| 推理方式 | Similarity Matching | Autoregressive Generation |
Few-shot:
CLIP:
1 | 少量标注图片 |
LLM 的 few-shot 不影响模型参数
| CLIP | LLM | |
|---|---|---|
| Example 的形式 | 标注图像 | Prompt 中的示例 |
| 是否更新 Backbone | 否 | 否 |
| 是否训练新参数 | 训练分类头 | 否 |
| Adaptation 方式 | Parameter Learning | In-Context Learning |
BLIP
在 CLIP 图文对齐思路的基础上,进一步统一了视觉语言理解(Understanding)和生成(Generation)两类任务
早期问题:Encoder-based 模型擅长图文检索等理解任务,但不容易直接用于文本生成;Encoder-Decoder 模型适合生成任务,但在图文检索方面表现受限
MED:让同一个预训练框架同时支持理解和生成
MED
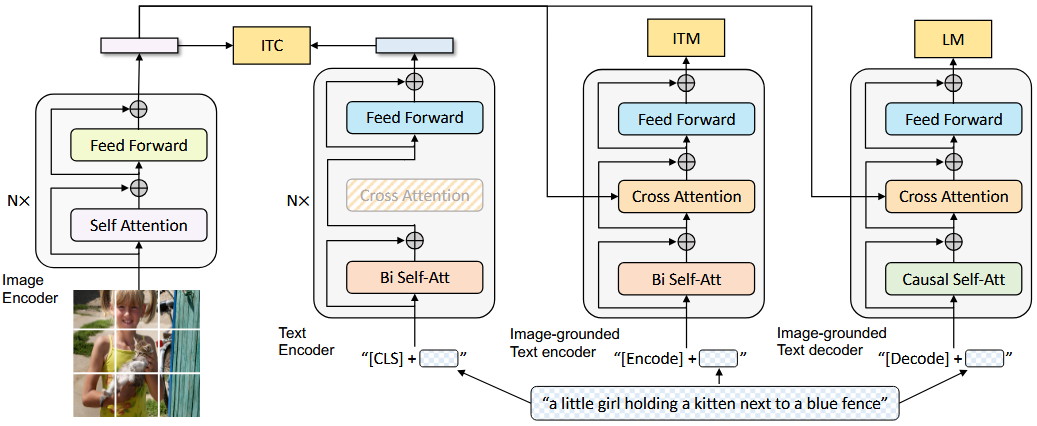
与CLIP相比真正变化的是文本这一侧,可以切换三种模式:
| 模式 | 主要结构 | 作用 |
|---|---|---|
| Unimodal Encoder | Image Encoder + Text Encoder | 独立提取图文特征 |
| Image-grounded Text Encoder | Text Encoder + Cross-Attention | 融合图文特征,判断是否匹配 |
| Image-grounded Text Decoder | Text Decoder + Cross-Attention | 基于图像自回归生成文本 |
- Image Encoder:使用 ViT,将图像切分为 Patch 并编码,利用
[CLS]表示全局图像特征 - Text Encoder:使用 BERT 类结构,通过双向 Self-Attention 获取文本表示
- Image-grounded Text Encoder:在文本 Transformer 中加入 Cross-Attention,使文本能够关注图像特征
- Image-grounded Text Decoder:将双向 Self-Attention 替换为 Causal Self-Attention,根据图像逐 Token 生成文本
Text Encoder 和 Text Decoder 共享除 Self-Attention 外的参数,包括 Embedding、Cross-Attention 和 FFN
原因是理解任务需要双向上下文,而生成任务需要因果掩码,两者对 Self-Attention 的要求不同
训练目标
BLIP 联合优化两个理解任务目标和一个生成任务目标。
| Loss | 全称 | 核心作用 |
|---|---|---|
| ITC | Image-Text Contrastive Loss | 图文特征空间对齐,类似CLIP |
| ITM | Image-Text Matching Loss | 图文细粒度匹配 |
| LM | Language Modeling Loss | 根据图像生成文本 |
CapFilt
BLIP 不直接完全相信原始 Web Text,因为其中存在较多与图像内容不匹配的噪声文本
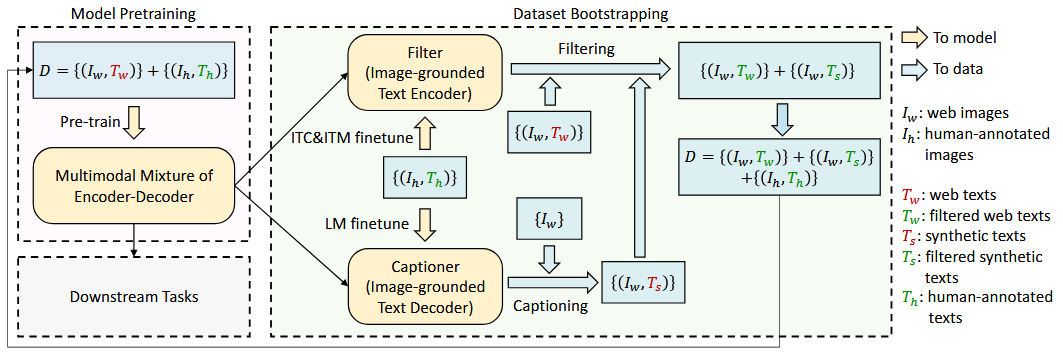
具体过程:
- 先利用原始数据预训练 MED
- 将预训练模型分别微调成 Captioner 和 Filter,使用 COCO 人工标注数据
- Captioner 为网络图像生成合成描述(每张图像生成一条)
- Filter 使用 ITM 判断图文是否匹配,过滤原始描述和生成描述中的噪声
- 将保留的图文对与人工标注数据合并,重新预训练一个模型
BLIP2
BLIP 已经通过 MED 统一了视觉语言理解与生成,但仍然需要训练较大规模的多模态模型,计算成本较高
BLIP-2 希望直接利用已经训练好的单模态模型:
- 预训练 Image Encoder:已经具备较好的视觉特征提取能力
- 预训练 LLM:已经具备较强的语言理解和生成能力
但两者存在模态差异
通过两阶段训练实现高效的视觉语言对齐,先学习图文表示对齐,再学习让 LLM 理解视觉特征
Q-Former
Q-Former 并不是简单的线性映射,而是一个使用可学习 Query 主动提取视觉特征的 Transformer,不是由用户输入的文本生成的
通过 Cross-Attention 与冻结视觉编码器的输出交互
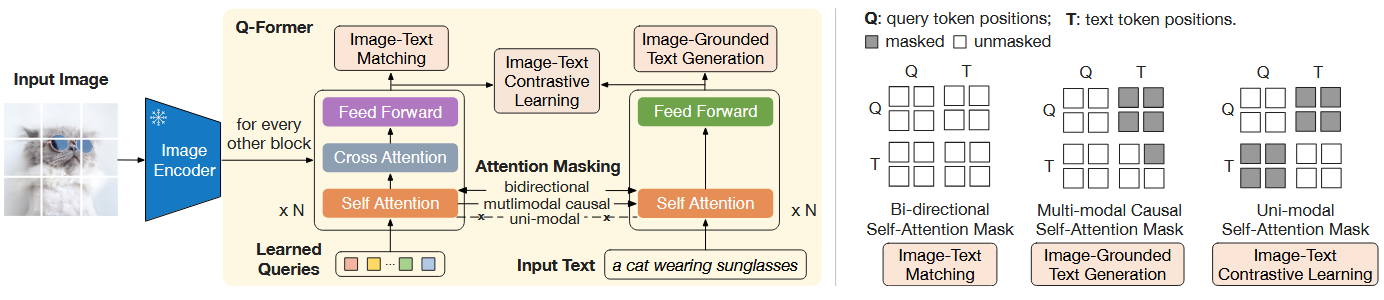
使得每个 Query 可以从图像特征中聚合信息
论文给出的 ViT-L/14 视觉特征形状是 257 × 1024,而 Q-Former 输出为 32 × 768
因此 Q-Former 也起到 Information Bottleneck 的作用,将较长的视觉特征序列压缩成固定数量的视觉 Token
BLIP
1 | Image → Image Encoder → Image Features |
文本 Token 直接通过 Cross-Attention 读取图像特征
BLIP-2
1 | Image → Frozen Image Encoder |
关键区别在于:
- BLIP 主要由文本 Token 在跨模态融合过程中读取视觉特征
- BLIP-2 额外引入 32 个可学习 Query,主动从视觉特征中提取信息
两阶段预训练
第一阶段:Vision-Language Representation Learning
目标:让 Q-Former 学会提取与文本语义相关的视觉特征
沿用 BLIP 的多任务学习思路,联合优化三个目标
让 Query 提取与语言相关、且具有细粒度语义信息的视觉特征
第二阶段:Vision-to-Language Generative Learning
目标:让 Q-Former 输出的视觉特征能够被冻结的 LLM 理解
展示了两种 LLM 接入方式
- Q-Former 提取视觉特征。
- FC 层将视觉特征映射到 LLM 的词嵌入维度。
- 将投影后的视觉特征作为 Soft Visual Prompts,与文本输入一起送入 LLM。
- 通过文本生成损失训练连接模块,LLM 本身保持冻结。
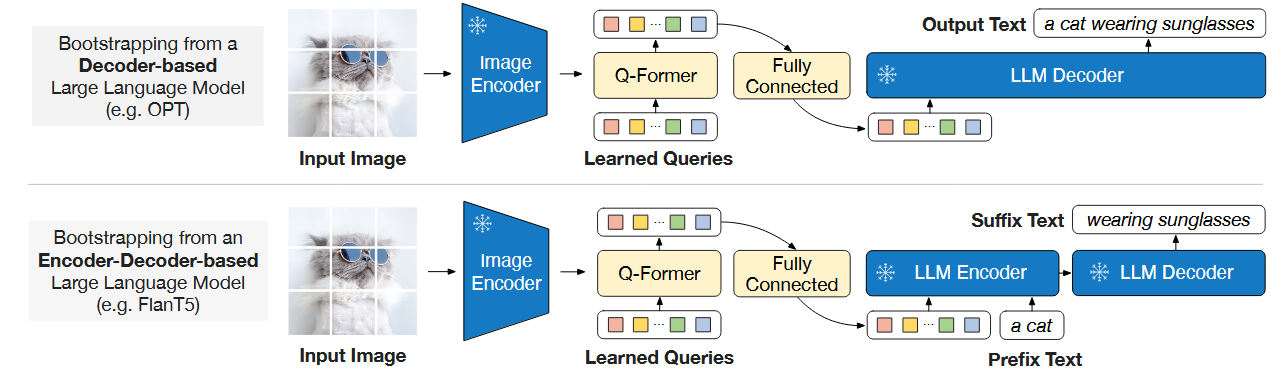
两阶段训练的区别:
- 第一阶段解决:如何从图像中提取与语言相关的信息?
- 第二阶段解决:如何让已有 LLM 利用这些视觉信息进行生成?
BLIP2的核心:可以保留预训练单模态模型的能力,仅训练较小的跨模态连接模块,实现视觉信息向语言模型的迁移。无需联合训练整个大模型,也能实现多模态理解与生成
LLaVA
CLIP、BLIP、BLIP-2 已经实现了图文对齐、图文匹配和视觉条件文本生成,但这些能力不完全等同于遵循用户指令完成视觉任务
LLaVA 的重点是将文本 LLM 中已经取得效果的 Instruction Tuning(指令微调) 扩展到视觉语言任务
模型架构
与 BLIP-2 相比,LLaVA 的模型连接方式更加简单
三个核心模块:
- Vision Encoder:使用预训练的 CLIP ViT-L/14,提取图像 Patch 特征
- Projection Layer:一个可训练的线性映射层,将视觉特征转换到 LLM 的词嵌入空间
- LLM:使用 Vicuna,根据图像特征和文本指令自回归生成回答
与 BLIP-2 最大的架构区别:LLaVA 不使用 Q-Former,而是直接利用 Linear Projection 连接 CLIP 与 LLM
多模态指令数据构建
核心贡献
传统图文配对数据通常是:
1 | Image: 一辆停在车库里的 SUV |
但用户实际输入往往是一个问题,而非要求生成固定的 Caption
具体做法:
- 从 COCO 获取图像及其 Captions、Bounding Boxes。
- 将这些信息整理成文本形式,让 GPT-4 获得图像的符号化描述。
- GPT-4 根据这些文本信息生成问题与回答。
- 将原始图像与生成的指令问答组合成训练样本。
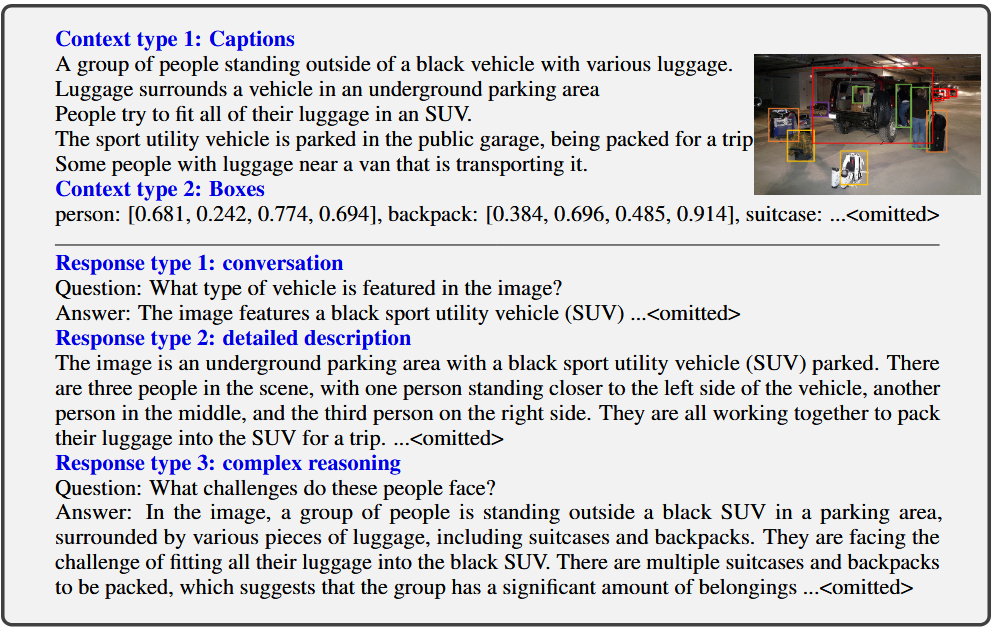
两阶段训练
LLaVA 同样采用两阶段训练,但与 BLIP-2 的训练方式不同
第一阶段:Feature Alignment(特征对齐)
目标:让视觉特征能够适配 LLM 的词嵌入空间
图像经过 CLIP 和 Projection 后,作为视觉 Token 输入 LLM,训练模型根据图像生成对应的 Caption
只训练 Projection Layer,为冻结的 LLM 训练一个兼容的 Visual Tokenizer
第二阶段:Visual Instruction Tuning(视觉指令微调)
目标:让模型根据视觉信息理解并遵循用户指令
与第一阶段不同:
- 视觉编码器仍然冻结。
- Projection Layer 继续更新。
- LLM 参数也参与训练,学习如何根据图像和指令生成回答
训练使用自回归语言建模目标,只对 Assistant 的回答 Token 和停止标记计算 Loss[和大模型的微调保持一致]
| 模型 | 核心设计 | 重点 |
|---|---|---|
| CLIP | Dual Encoder + Contrastive Learning | 图文语义对齐 |
| BLIP | MED + CapFilt | 统一理解与生成 |
| BLIP-2 | Frozen Encoder + Q-Former + Frozen LLM | 高效连接视觉编码器和 LLM |
| LLaVA | CLIP + Linear Projection + Vicuna | 多模态指令微调 |
BLIP-2 重点解决的是:如何在冻结视觉编码器和 LLM 的情况下,通过 Q-Former 高效实现视觉语言对齐?
LLaVA 重点解决的是:如何通过简单的视觉连接模块和高质量视觉指令数据,让 LLM 学会根据图像遵循用户指令?
Qwen2-VL
[2409.12191] Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution
CLIP、BLIP-2、LLaVA 等模型已经建立了视觉编码器与语言模型之间的连接,但仍面临一些问题
- 固定图像分辨率:传统模型通常将图像缩放到固定尺寸(如 224×224),导致高分辨率图像中的文字和细节丢失
- 视觉空间建模不足:将图像 Token 当作普通一维序列处理,难以充分保留二维空间信息
- 视频时序理解不足:图像和视频经常被作为不同模态处理,缺少统一的时空位置表示
Qwen2-VL 针对这些问题,重点提升模型对不同分辨率图像、文档以及视频的理解能力