扩散模型
视觉潜空间
| 模型 | 任务目标 | 训练损失 |
|---|---|---|
| VAE | 图像压缩与重建,学习连续潜空间 | Reconstruction Loss + KL Loss |
| VQ-VAE | 图像压缩与重建,学习离散潜空间 | Reconstruction Loss + Codebook Loss + Commitment Loss |
| VQGAN | 高质量图像压缩与重建,学习离散视觉 Token | Perceptual Loss + Codebook Loss + Adversarial Loss |
VAE
核心思想: 将输入映射为潜变量的概率分布,通过采样获得 Latent Representation,再利用 Decoder 重建数据,同时通过 KL Divergence 约束潜空间,使其形成连续且规整的分布,从而实现数据生成
后续扩散模型其实大部分还是采用预训练 VAE
模型架构
VAE 采用 Encoder-Decoder 结构:
- Encoder:将输入映射为高斯分布的参数,包括均值 $\mu$ 和标准差 $\sigma$
- Sampling:通过重参数化技巧,从潜变量分布中采样得到 $z$
- Decoder:根据潜变量 $z$ 重建原始输入。
与普通 Autoencoder 不同,VAE 输出的是概率分布,而不是确定性的特征向量
重参数化
为了使随机采样过程能够进行梯度反向传播,VAE 将采样过程表示为:
核心作用: 将随机性转移到独立噪声变量,使模型能够通过反向传播更新 Encoder 参数
Loss Function(ELBO)
VAE 通过最大化 ELBO 进行训练,实际通常最小化其负值:
- Reconstruction Loss:保证 Decoder 能够根据潜变量重建原始数据
- KL Divergence:约束近似后验分布接近标准正态先验,使潜空间更加连续、规整
通常采用标准正态分布作为先验:
训练完成后,可以直接从标准正态分布采样潜变量,再输入 Decoder 生成新数据:
1 | z ~ N(0, I) |
VQ-VAE
核心思想: 将 Encoder 输出的连续特征映射到 Codebook 中距离最近的 Embedding,得到离散潜变量,再通过 Decoder 重建输入,从而学习离散潜空间
Vector Quantization(向量量化)
VQ-VAE 保留 Encoder-Decoder 结构,但在两者之间引入 Codebook:
- Encoder 将输入映射为连续特征 $z_e(x)$
- 通过 Codebook 查找距离最近的 Embedding
- 将对应的 Embedding 作为离散化后的潜变量 $z_q(x)$
- Decoder 根据量化后的潜变量重建输入
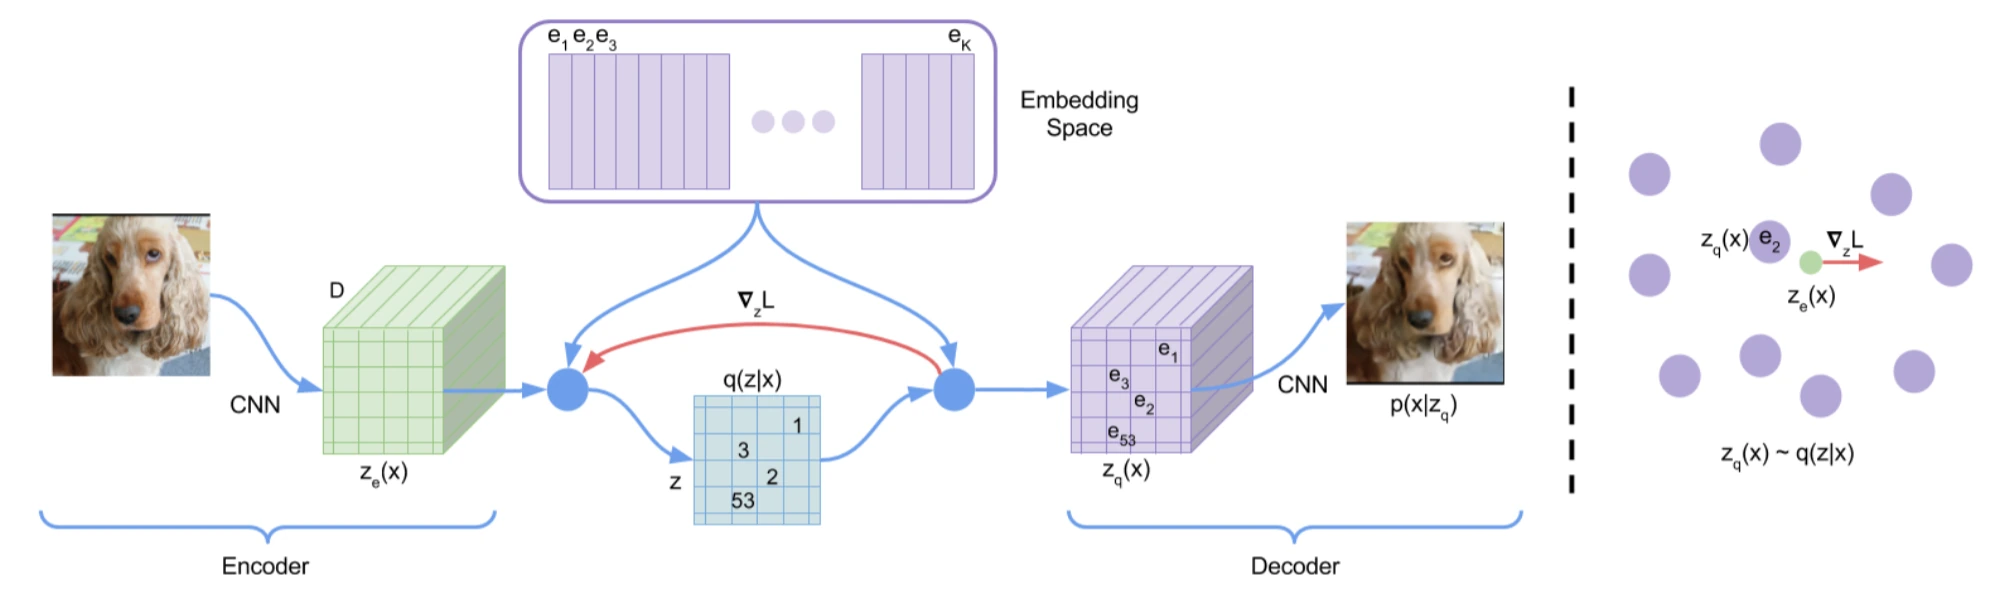
Codebook 包含 $K$ 个 $D$ 维 Embedding:
最近邻量化过程:
1 | Token ID |
而 VQ-VAE 在编码阶段相当于反过来
1 | Encoder Feature |
模型自己学习了一套离散表示,使得连续空间变成了有限的离散状态
Straight-Through Estimator(直通梯度估计)
最近邻量化涉及离散索引选择,无法直接进行梯度反向传播
VQ-VAE 引入 STE:
- Forward: 正常执行最近邻量化,将 $z_q(x)$ 输入 Decoder
- Backward: 将 Decoder 输入端的梯度直接复制到 Encoder 输出 $z_e(x)$,跳过量化操作
近似认为:
核心作用: 使梯度能够跨越不可微分的量化操作,更新 Encoder 参数
Loss Function
VQ-VAE 的训练目标包含三个部分:
Reconstruction Loss:保证 Decoder 能够根据量化后的潜变量重建原始输入,通过 STE 更新 Encoder 和 Decoder
Codebook Loss:使 Codebook 中的 Embedding 向 Encoder 输出靠近
Commitment Loss:约束 Encoder 输出靠近选中的 Embedding,避免 Encoder 特征不断偏离 Codebook
| Loss | Encoder | Codebook | Decoder |
|---|---|---|---|
| Reconstruction Loss | ✓ | × | ✓ |
| Codebook Loss | × | ✓ | × |
| Commitment Loss | ✓ | × | × |
相比 VAE,不再使用标准正态分布的 KL 正则化,而是通过 Codebook 学习离散潜变量
VQ-VAE 的核心: 通过可学习的 Codebook 将连续视觉特征离散化,使图像能够表示为离散 Token 序列,为后续 VQGAN 和基于 Transformer 的视觉生成模型奠定基础
VQGAN
[2012.09841] Taming Transformers for High-Resolution Image Synthesis
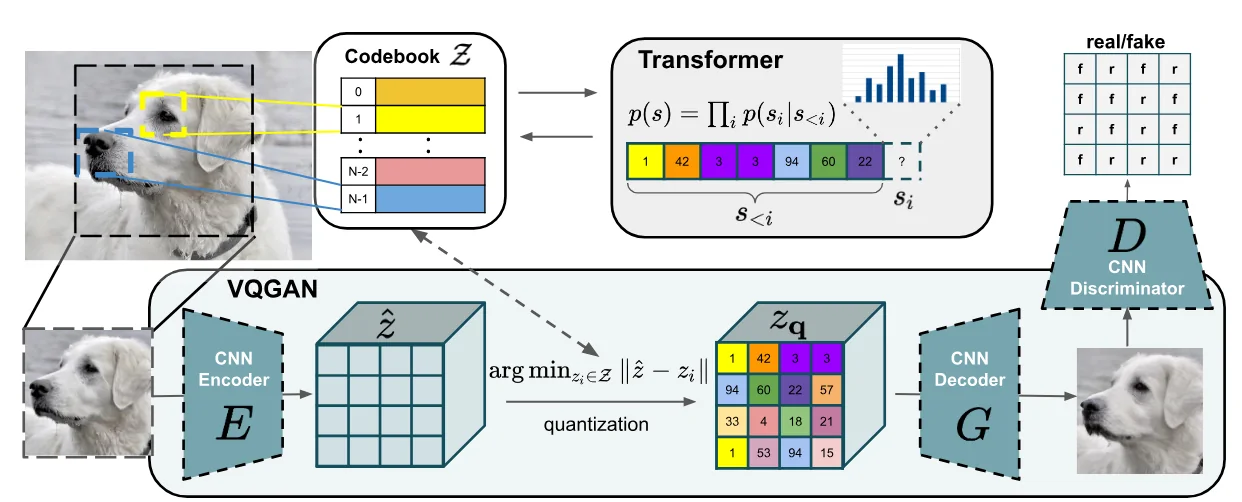
核心思想: 在 VQ-VAE 的离散潜空间基础上,引入 Perceptual Loss 和 GAN 对抗训练,提高图像压缩后的感知质量,再使用 Transformer 建模离散视觉 Token 之间的关系,实现高分辨率图像生成
Perceptual Compression(感知压缩)
VQ-VAE 使用 Pixel-level Reconstruction Loss,直接约束重建图像与原始图像之间的像素差异,但在较高压缩率下容易损失细节,产生模糊的重建结果
VQGAN 对此进行了两项改进:
- Perceptual Loss:利用预训练特征网络提取图像特征,约束重建图像与原始图像在感知特征空间中的差异。
- Patch-based Discriminator:引入基于图像块的判别器,通过对抗训练提高重建图像的真实性
Loss Function
VQGAN 在原有 VQ-VAE 损失基础上,将像素级重建损失替换为感知重建损失,并增加 GAN 对抗损失:
其中:
- $\mathcal L_{\mathrm{VQ}}$:包含感知重建损失、Codebook Loss 和 Commitment Loss
- $\mathcal L_{\mathrm{GAN}}$:通过判别器区分真实图像和重建图像
- $\lambda$:自适应调整对抗损失的权重,根据 Decoder 最后一层的梯度平重建目标与对抗目标
核心作用: 在较高压缩率下,尽可能保留图像的感知质量和细节真实性
Transformer 建模
VQGAN 的另一个重要贡献是使用 Transformer 建模离散视觉 Token 之间的依赖关系
整体分为两个阶段:
Stage 1:训练 VQGAN
- CNN Encoder 提取图像特征
- 通过 Codebook 进行向量量化,得到离散视觉 Token
- Decoder 根据量化特征重建图像
Stage 2:训练 Transformer
- 将图像转换为离散 Token 序列(Codebook编号序列)
- 使用自回归 Transformer 学习 Token 之间的组合关系
- 根据前面的 Token 预测下一个 Token
其生成过程可以表示为:
经典扩散模型
| 模型 | 任务目标 |
|---|---|
| U-Net | 图像分割,提取多尺度特征并预测像素类别 |
| DDPM | 无条件图像生成 |
| Improved DDPM | 改善 DDPM 生成质量 |
| DDIM | 加速 DDPM 采样 |
| Score SDE | 基于连续时间 Score Matching 的生成建模 |
U-Net
[1505.04597] U-Net: Convolutional Networks for Biomedical Image Segmentation
核心思想: 采用对称的 Encoder-Decoder 架构,通过 Encoder 提取多尺度上下文特征,再利用 Skip Connection 将浅层空间细节传递给 Decoder,实现高层语义信息与低层空间信息的融合
整体架构
U-Net 主要由三个部分组成:
- Encoder(Contracting Path):逐步降低特征图分辨率,提取高层语义和上下文信息
- Decoder(Expansive Path):逐步恢复特征图分辨率,生成目标输出
- Skip Connection:将 Encoder 对应层的特征传递给 Decoder,通过 Concatenation 融合不同层级的信息

Encoder-Decoder
Encoder:
- 使用卷积提取局部特征
- 通过 Max Pooling 逐步降低空间分辨率
- 随着分辨率降低,增加特征通道数,扩大感受野
Decoder:
- 通过上采样逐步恢复空间分辨率
- 融合 Encoder 对应层的特征
- 通过卷积进一步提取融合后的特征
Skip Connection
这是 U-Net 最重要的设计
Encoder 在下采样过程,虽然能够提取更大范围的上下文信息,但空间分辨率降低会导致部分细节丢失
Decoder 仅依靠上采样难以完全恢复这些细节
因此,U-Net 将 Encoder 对应层的高分辨率特征直接传递给 Decoder,并通过 Concatenation 进行融合
核心作用: 同时利用深层特征的语义信息和浅层特征的空间细节,提高输出的精细程度
在扩散模型中的应用
DDPM 将 U-Net 作为去噪网络(Denoising Network),输入带噪图像$ x_t$ 和时间步 $t$,预测其中包含的噪声
相比原始 U-Net,扩散模型中的 U-Net 增加了时间步 Embedding,使网络能够根据不同噪声程度执行对应的去噪任务
DDPM
核心思想: 通过前向过程(Forward Process)逐步向数据添加高斯噪声,再训练神经网络学习反向去噪过程(Reverse Process),使模型能够从随机噪声逐步恢复出真实图像
DDPM 将生成过程建模为一个 Markov Chain(马尔可夫链),包含两个过程:
- Forward Process:逐步破坏原始图像,最终得到标准高斯噪声。
- Reverse Process:学习逐步去除噪声,从随机噪声恢复图像。
与 VAE 不同,DDPM 中的 $x_t$ 与原始图像 $x_0$ 具有相同维度,并不是经过 Encoder 压缩得到的低维潜变量

Forward Process
通过不断向原始图像添加高斯噪声,使图像逐渐失去原有信息。
每个时间步的加噪过程定义为:
其中,$\beta_t$ 为噪声调度参数(Noise Schedule),控制每一步添加的噪声强度
定义:
核心作用: 不需要逐步执行加噪过程,可以直接从原始图像构造任意时间步的带噪图像
Reverse Process
反向过程从标准高斯噪声开始,逐步恢复原始图像
定义反向转移分布:
Noise Prediction
DDPM 最重要的设计:不直接预测去噪后的图像,而是让网络预测前向过程中添加的噪声 $\epsilon$
通过噪声预测结果,可以计算反向过程的均值:
$\mu_\theta$ 就是模型认为下一步图像应该处于的位置
得到反向采样公式:
Training & Sampling
Training:
- 从数据集中采样原始图像 $x_0$
- 随机采样时间步 $t$ 和高斯噪声 $\epsilon$
- 根据 Forward Process 构造带噪图像 $x_t$
- 将 $(x_t,t)$ 输入 U-Net,预测噪声
- 使用 MSE Loss 优化预测噪声与真实噪声之间的误差
训练目标:
- 从标准高斯分布采样初始噪声 $x_T$
- 将 $(x_t,t)$ 输入训练好的 U-Net,预测噪声
- 根据反向采样公式计算 $x_{t-1}$
- 从 $T$ 逐步迭代至 $1$,得到最终图像 $x_0$
U-Net Architecture
DDPM 使用 U-Net 作为噪声预测网络,在经典 U-Net 基础上增加三个重要模块:
- Residual Block: 通过残差结构提取特征,构建更深的网络
- Self-Attention: 建模不同空间位置之间的全局依赖
- Time Embedding: 将扩散时间步 $t$ 编码为正弦位置嵌入,并注入每个 Residual Block,使网络能够感知当前噪声水平
不同时间步对应不同程度的噪声,网络需要根据时间步调整去噪行为
Improved DDPM
[2102.09672] Improved Denoising Diffusion Probabilistic Models
核心思想: 在 DDPM 的基础上,通过学习反向过程的方差、改进噪声调度策略和优化训练目标,提高模型的生成质量、似然估计能力和采样效率
Learned Variance
原始 DDPM 将反向过程的方差固定为预设值,只学习反向过程的均值
Improved DDPM 让模型同时预测反向过程的均值和方差:
- $\beta_t$:前向过程的噪声方差
- $\tilde\beta_t$:真实后验分布的方差
- $v$:网络预测的插值系数
因此,U-Net 除了预测噪声,还需要额外预测方差参数
核心作用: 让模型自适应学习每一步反向去噪的不确定性,使模型能够在较少采样步数下保持较好的生成质量
Cosine Noise Schedule
原始 DDPM 使用 Linear Schedule,随着时间步增加,噪声逐渐增强
但在低分辨率图像上,Linear Schedule 可能过早破坏图像信息,导致扩散后期的大量时间步输入几乎都是纯噪声
Improved DDPM 提出 Cosine Schedule,通过余弦函数控制累计信号保留比例:
- $T$:总扩散步数。
- $s$:平滑偏移量,论文设置为 0.008
再根据累计信号保留比例计算每一步的噪声方差:
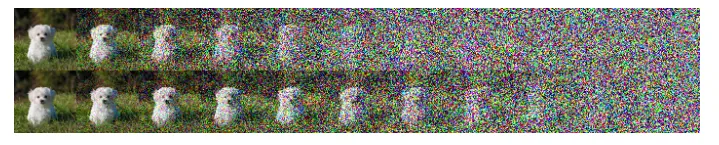
上为线性加噪,下为余弦加噪

Hybrid Loss
原始 DDPM 采用简化的噪声预测 MSE Loss,训练稳定,但并不直接优化完整的 Variational Lower Bound(VLB)
Improved DDPM 将简化损失与 VLB 结合:
- Simple Loss:通过噪声预测训练反向过程的均值
- VLB Loss:通过变分下界优化模型的概率分布,特别是学习反向过程的方差
在计算 VLB 时对均值预测分支使用 Stop Gradient,避免高方差梯度干扰噪声预测
Importance Sampling
直接优化 VLB 时,不同时间步的 Loss 差异较大,均匀采样时间步容易产生较大的梯度噪声
引入 Importance Sampling,根据不同时间步 Loss 的历史统计量调整采样概率
DDIM
核心思想: 在保留 DDPM 噪声预测训练目标的基础上,构造非马尔可夫扩散过程,重新设计反向采样轨迹,使模型能够跳过部分去噪步骤,实现更快的图像生成
Non-Markovian Diffusion
DDPM 的 Forward Process 是一个 Markov Chain,每个时间步只依赖前一个时间步:
Reverse Process
DDIM 沿用 DDPM 训练好的噪声预测网络,首先根据当前带噪图像估计原始图像:
- 第一项:预测的原始图像所对应的信号部分
- 第二项:根据当前预测噪声确定去噪方向
- 第三项:额外引入的随机噪声,控制采样随机性,$z\sim\mathcal N(0,I)$

确定性采样
DDIM 最重要的特点是可以通过调整 $ \sigma_t$ 控制反向过程的随机程度
当设置 $\sigma_t=0$ 时
给定相同的初始噪声、模型和时间步序列,每次都会得到相同的生成结果
加速采样
DDPM 通常需要按照完整时间步逐步去噪,例如 $T=1000$ 时需要执行 1000 次网络推理
DDIM 可以选择一个较短的时间步子序列:
DDIM 可以在不重新训练模型的情况下,通过减少采样步数提高生成速度
但无法一次到位:因为高噪声状态下预测噪声存在误差,直接反推原始图像会放大误差,多次迭代可以不断修正
Score SDE
[2011.13456] Score-Based Generative Modeling through Stochastic Differential Equations
核心思想: 将离散时间的噪声扰动过程推广到连续时间,通过学习不同噪声水平下数据分布的 Score Function,构造反向 SDE(随机微分方程),从而实现从随机噪声到真实数据的生成
Score 表示当前数据点在概率分布中,朝向概率密度更高区域的梯度方向
SMLD
[1907.05600] Generative Modeling by Estimating Gradients of the Data Distribution
SMLD(Score Matching with Langevin Dynamics)是 DDPM 之前的重要 Score-based Generative Model,采用离散噪声等级进行训练
主要过程:
- Noise Perturbation: 设置多个递增的噪声等级,分别向原始数据添加高斯噪声
- Score Matching: 训练 Noise Conditional Score Network(NCSN),预测不同噪声等级下的 Score Function
- Annealed Langevin Dynamics: 从较大噪声等级开始,逐渐降低噪声,利用 Score 引导样本向真实数据分布移动
SMLD 使用离散噪声等级,需要设计多个噪声尺度
Score SDE 则将噪声扰动推广到连续时间,建立统一的数学框架
Score Function
Score Function 定义为数据分布对数概率密度关于输入的梯度:
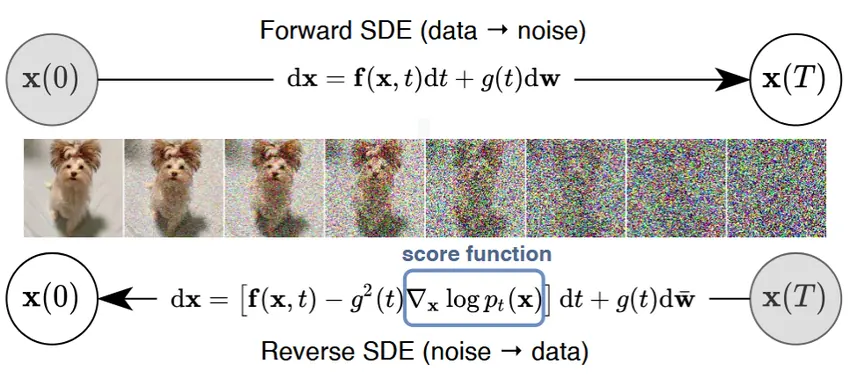
在扩散过程中,数据分布会随着噪声水平变化,因此需要估计不同时刻扰动分布的 Score:
Denoising Score Matching(DSM):
直接计算真实数据分布的 Score 通常比较困难,因此使用加噪时的高斯条件分布构造监督信号,让网络学习扰动数据分布的 Score。
对于高斯扰动,可以根据已知的噪声计算条件 Score,从而训练 Score Network
模型不是预测原始图像,而是预测当前噪声水平下的数据分布梯度
Forward SDE
DDPM 和 SMLD 都通过逐步添加高斯噪声破坏数据,但它们采用不同的噪声调度方式
Score SDE 将这些离散扰动过程统一推广为连续时间随机微分方程:
- $f(x,t)$:Drift Coefficient(漂移系数),控制数据随时间的变化方向
- $g(t)$:Diffusion Coefficient(扩散系数),控制噪声强度
- $w(t)$:标准 Wiener Process(布朗运动),$dw$ 表示其随机增量
随着时间 $t$ 从 $0$ 增加到 $T$,数据分布逐渐被噪声扰动,最终接近已知的先验分布,通常为标准高斯分布
Reverse SDE
前向 SDE 负责将真实数据逐渐扰动为噪声,而生成过程需要反向执行这一过程
可以利用数据分布的 Score Function 构造对应的反向 SDE
- $\nabla_x\log p_t(x)$:由训练好的 Score Network 进行估计
- $d\bar w$:反向时间的 Wiener Process 增量
- $dt$:反向积分时为负的时间增量,整个过程从 $T$ 积分到 0
Score Function 提供反向去噪所需的分布梯度,使模型能够从先验噪声逐步恢复真实数据
Probability Flow ODE(概率流常微分方程)
论文进一步证明,可以构造一个与 Forward SDE 具有相同边缘概率分布的确定性 ODE:
两者的区别:
| 对比 | Reverse SDE | Probability Flow ODE |
|---|---|---|
| 数学形式 | 随机微分方程 | 常微分方程 |
| 随机噪声 | 包含 | 不包含 |
| 生成轨迹 | 随机 | 确定性 |
| 初始噪声相同 | 轨迹仍受随机项影响 | 轨迹唯一 |
核心作用: 提供了一种确定性生成路径,也使扩散模型可以使用 ODE Solver 进行采样和似然计算
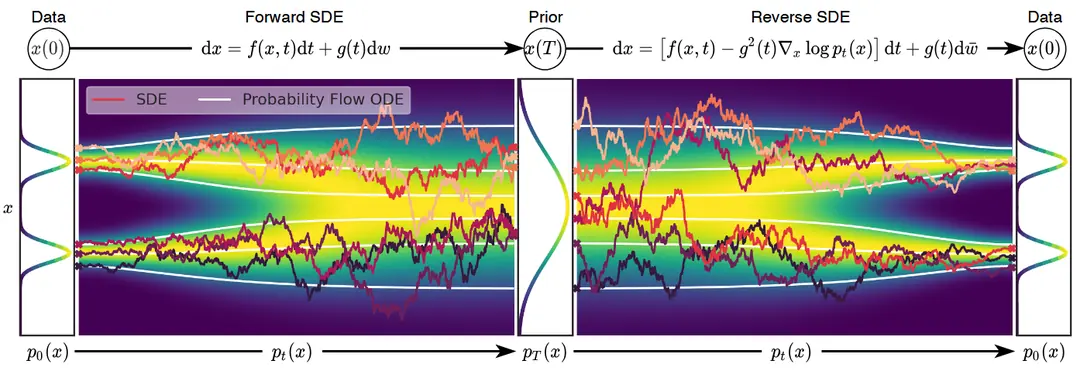
统一框架
Score SDE 将 DDPM 和 SMLD 统一到连续时间 SDE 框架中:
| 类型 | 对应模型 | 特点 |
|---|---|---|
| VP-SDE(Variance Preserving) | DDPM | 原始信号逐渐衰减,向零收缩; 控制信号与噪声的比例,方差保持在一定范围内 |
| VE-SDE(Variance Exploding) | SMLD | 不主动衰减原始信号,逐渐增大噪声方差 |
通过不同的 Drift Coefficient(漂移系数)和 Diffusion Coefficient(扩散系数),可以构造不同的前向扰动过程,并统一使用 Score Function 建立反向生成过程
条件生成与潜空间扩散
| 模型 | 任务目标 |
|---|---|
| CFG | 提高条件生成的可控性 |
| LDM | 在低维潜空间进行扩散生成 |
CFG
核心思想: 在训练阶段随机丢弃条件信息,使同一个模型同时学习条件生成和无条件生成;在采样阶段组合两种预测结果,增强生成结果对条件信息的遵循程度
Classifier Guidance(分类器引导)
早期的 Classifier Guidance 需要额外训练一个分类器,利用分类器预测当前带噪图像属于目标类别的概率,并计算其梯度
但这种方法需要额外训练分类器,并在采样过程中计算分类器梯度,增加了模型复杂度和计算开销
CFG 的核心改进是:不再依赖额外分类器,而是利用扩散模型自身的条件和无条件预测实现引导
Classifier-Free Training(无分类器训练)
CFG 使用同一个网络学习两种生成模式:
- Conditional Generation: 输入带噪图像 $x_t$、时间步 $t$ 和条件 $c$
- Unconditional Generation: 将条件替换为空条件 $\varnothing$,学习无条件生成
训练时,以一定概率 $p_{\mathrm{uncond}}$ 随机丢弃条件信息
Guidance Sampling(引导采样)
采样阶段,分别计算条件和无条件噪声预测:
最后将引导后的噪声预测代入原有反向采样过程,完成去噪生成
Guidance Scale(引导强度)
通过调整 $w$,可以控制条件引导的强度:
- $w=0$:仅使用条件预测,不进行额外引导
- $w$ 增大:增强条件引导,提高生成结果与条件的匹配程度,但通常会降低生成多样性
- $w$ 过大:可能导致生成结果过度饱和,影响图像质量
CFG 实现了生成质量(Sample Fidelity)与生成多样性(Sample Diversity)之间的权衡
LDM(Latent Diffusion Models)
[2112.10752] High-Resolution Image Synthesis with Latent Diffusion Models
核心思想: 将扩散模型从高维 Pixel Space 转移到低维 Latent Space,先通过预训练 Autoencoder 压缩图像,再在潜空间中执行扩散和去噪,最后通过 Decoder 恢复图像,从而降低计算成本,同时保留较好的生成质量
Perceptual Compression(感知压缩)
传统 DDPM 直接在 Pixel Space 中进行扩散,需要对高维图像反复执行 U-Net,计算成本较高
LDM 将图像生成分为两个阶段:
- Perceptual Compression: 使用 Autoencoder 压缩图像,去除部分不重要的高频细节,保留主要视觉信息
- Semantic Compression: 使用 Diffusion Model 在低维潜空间中学习数据的语义和概念组合关系
训练完成后,冻结 Autoencoder,在其潜空间中训练扩散模型
Latent Diffusion(潜空间扩散)
假设输入图像为 $x$,通过 Encoder 得到潜变量:
**生成过程:**随机噪声 → Latent Diffusion 去噪 → Decoder 解码 → 生成图像
核心作用: 将原本在高维像素空间进行的扩散计算转移到低维潜空间,大幅降低训练和推理成本
Cross-Attention(条件注入)
为了实现文本到图像等条件生成,LDM 在 U-Net 中引入 Cross-Attention,使模型能够接收不同模态的条件信息
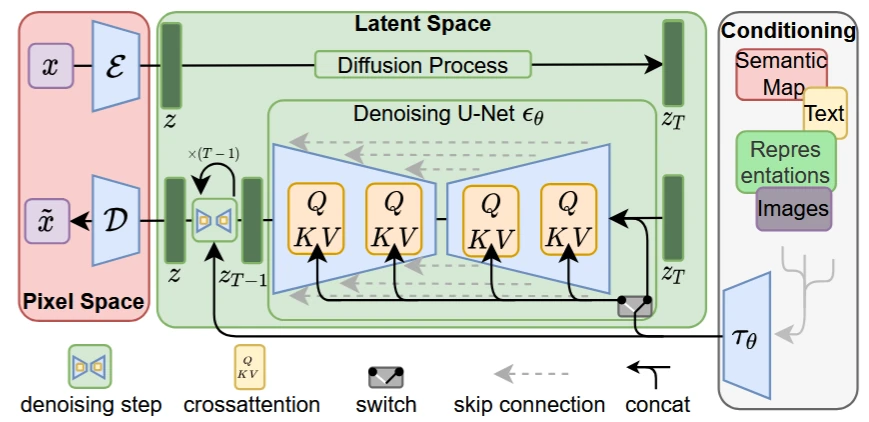
首先使用条件编码器 $\tau_\theta$ 将条件信息 $y$ 转换为特征表示:
这种机制支持多种条件输入,例如:
- Text-to-Image:文本生成图像
- Class-Conditional Generation:类别条件生成
- Layout-to-Image:根据布局生成图像
Training & Sampling
LDM 采用两个阶段进行训练:
Stage 1:训练 Autoencoder
- 使用 Perceptual Loss 和 Patch-based Adversarial Loss,提高重建图像的感知质量
- 使用 KL-Regularization 或 VQ-Regularization 约束潜空间
- 获得 Encoder 和 Decoder
Stage 2:训练 Latent Diffusion
- 冻结预训练 Autoencoder
- 将图像编码为潜变量
- 在潜空间中执行扩散和去噪训练
- 根据任务需求引入 Cross-Attention,学习条件生成
Stable Diffusion
CompVis/stable-diffusion: A latent text-to-image diffusion model
核心思想: 基于 LDM,将图像压缩到低维潜空间进行扩散,并结合 CLIP 文本编码器和 Cross-Attention,实现文本条件图像生成(Text-to-Image)
给定文本 Prompt,生成过程如下:
- Text Encoding: CLIP 将 Prompt 转换为文本特征
- Latent Initialization: 从随机高斯噪声初始化 Latent
- Denoising: U-Net 在文本条件引导下逐步预测噪声,完成潜空间去噪
- Decoding: 将最终 Latent 输入 VAE Decoder,恢复为图像
1 | Text Prompt |
生成范式演进
| 对比 | Flow Matching(FM) | Rectified Flow(RF) |
|---|---|---|
| 核心目标 | 学习概率路径对应的速度场 | 学习并优化噪声到数据的运输轨迹 |
| 路径设计 | 支持多种概率路径 | 重点采用线性插值 |
| 训练方式 | Conditional Flow Matching | 速度回归 + Rectification |
| 关键设计 | 通用速度场匹配框架 | Reflow 进一步拉直轨迹 |
| 主要优势 | 路径设计灵活、训练无需 ODE 模拟 | 轨迹更加平直,有利于减少采样步数 |
Flow Matching
核心思想: 不再像 DDPM 一样预测需要去除的噪声,而是直接学习从噪声到真实数据的运动方向和速度,通过 ODE 数值积分完成生成
Flow Matching
传统扩散模型通过逐步去噪,将随机噪声转换为真实图像
Flow Matching 则将生成过程理解为一个连续运动过程:
- 起点:随机高斯噪声
- 终点:真实图像
- 中间过程:噪声逐渐向真实图像转变
首先,构造从噪声到真实图像的 Probability Path,然后训练神经网络学习这条路径上的运动规律,即 Velocity Field
训练过程:
- 从噪声分布和真实数据集中分别采样样本
- 随机选择一个时间步,构造噪声与真实数据之间的中间状态
- 计算该状态对应的目标运动方向和速度
- 输入神经网络,让模型预测当前应该如何移动
- 使用 MSE Loss,让预测速度接近目标速度
核心: 模型学习的是 Velocity,而不是 DDPM 中的 Noise
Conditional Flow Matching
这是论文最重要的训练设计
直接计算整体概率路径对应的速度场比较困难,因为它涉及对所有真实数据样本对应的条件概率路径进行整合
论文通过给定具体的数据样本,构造更容易计算的条件概率路径,让模型学习对应的条件速度场
这样就可以利用简单的样本和速度计算完成训练,而不需要直接求解复杂的整体概率分布
将难以计算的 Flow Matching 训练目标转化为容易实现的监督学习问题,而且不需要在训练过程中运行 ODE 数值积分
Probability Path
Flow Matching 的重要特点是:不限定生成过程必须采用某一种固定路径,可以根据需要选择不同的概率路径
论文主要研究两类:
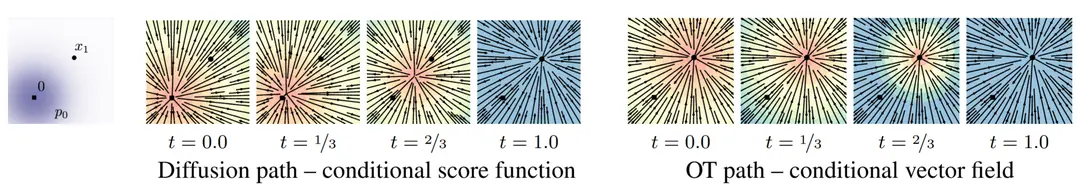
Diffusion Path: 采用类似传统扩散模型的概率路径,通过逐渐改变数据与噪声的比例实现分布转换
Optimal Transport Path: 基于最优传输,为噪声与真实数据构造直线形式的条件概率路径,使样本运动轨迹更加简单
$$ x_t= \left[1-(1-\sigma_{\min})t\right]x_0+tx_1 $$其中:- $x_0$:标准高斯噪声
- $x_1$:真实数据样本
- $\sigma_{\min}$:终点保留的最小噪声标准差
对应的目标速度为:
$$ u_t=x_1-(1-\sigma_{\min})x_0 $$当 $\sigma_{\min}$ 足够小时,路径近似为从噪声到数据的直线
相比 Diffusion Path,Optimal Transport Path 的条件轨迹更加直接,能够减少不必要的弯曲和回退,有利于模型学习和采样效率
Sampling
训练完成后,模型已经学会从噪声到数据的速度场
生成时,从随机高斯噪声出发,根据模型预测的速度不断更新样本,最终得到生成结果
其核心过程由 ODE(常微分方程)描述:
与传统随机反向扩散过程不同,Flow Matching 通常通过确定性 ODE 描述生成过程。给定相同的初始噪声、模型参数和条件输入,速度场及其积分轨迹在理论上是确定的。但由于初始噪声来自随机分布,不同次采样仍然可以生成不同结果
Rectified Flow
[2209.03003] Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow
- Flow Matching: 研究如何通过学习速度场,实现从噪声分布到数据分布的生成
- Rectified Flow: 进一步关注如何让生成轨迹尽可能直,从而减少生成时的数值积分步数
核心思想: 在 Flow Matching 的速度场学习基础上,采用噪声与真实数据之间的线性插值构造生成路径,并通过 Reflow(重新流化)不断优化噪声与数据之间的配对关系,使生成轨迹更加接近直线,从而减少采样步数
Rectified Flow
Rectified Flow 将噪声与真实数据之间的生成过程构造成直线路径:
- 起点:随机高斯噪声 $ x_0$
- 终点:真实数据 $x_1$
- 中间状态:通过线性插值得到
训练时,使用 MSE Loss,让神经网络学习当前样本应该移动的方向和速度
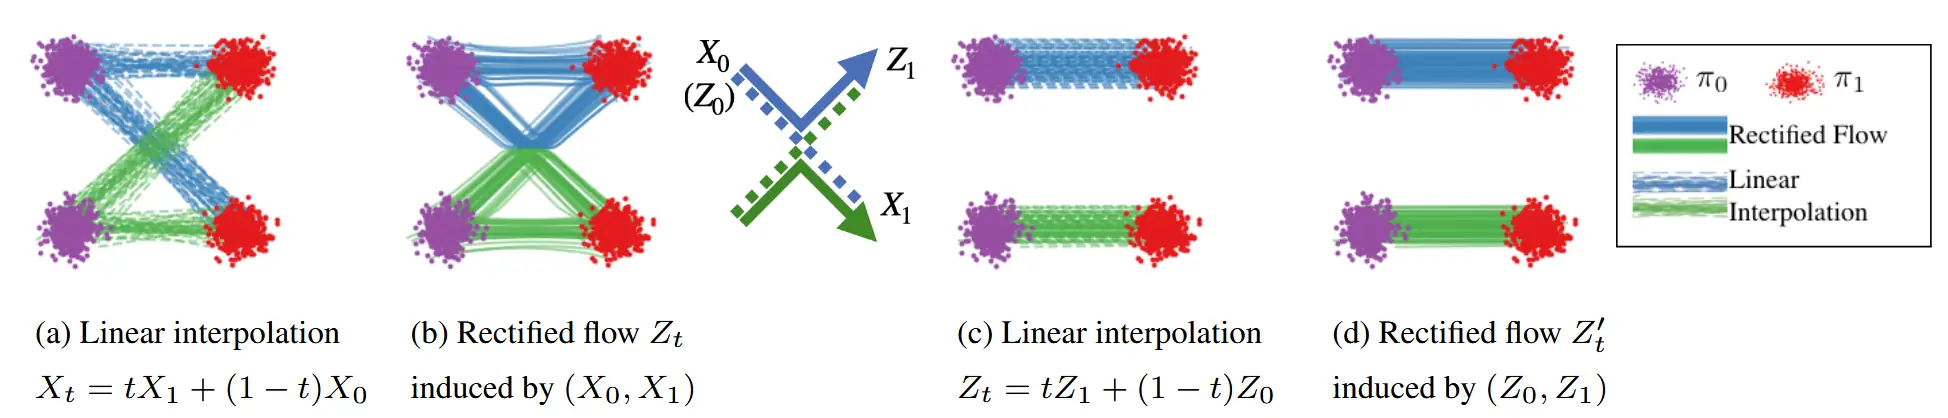
需要注意: 虽然最初构造的是直线路径,但不同样本的路径可能发生交叉
当多条路径经过同一位置时,可能存在不同的运动方向,模型需要对这些方向进行学习和整合。因此,最终学习到的 ODE 轨迹不一定完全是直线
Rectification & Reflow(轨迹整流)
这是 Rectified Flow 最重要的设计
第一次训练(Rectification):
- 随机采样噪声和真实图像,构造线性插值路径
- 训练网络预测路径对应的速度
- 得到能够将噪声分布映射到数据分布的 ODE
再次训练(Reflow):
- 使用第一次训练好的模型,从随机噪声出发,通过 ODE 生成对应的图像
- 将初始噪声与生成图像组成新的配对
- 使用新的配对重新构造线性插值路径
- 重新训练速度场,使生成轨迹进一步趋于直线
通过重复 Reflow,可以逐渐减少轨迹交叉和弯曲,使生成路径更加直接
Sampling
Rectified Flow 的主要优势是生成轨迹更加接近直线
传统扩散模型通常需要较多步数完成去噪,而弯曲的 ODE 轨迹也需要较密集的数值积分
当生成轨迹接近直线时,可以使用更大的时间步长进行数值积分,减少模型调用次数
理想情况下,如果轨迹完全是直线,甚至可以通过一次 Euler Step 完成生成
原论文实验表明,经过 Reflow 后,模型能够使用极少的采样步数生成高质量图像,部分实验甚至可以使用单步采样
现代扩散架构
DiT(Diffusion Transformer)
核心思想: 将传统扩散模型的 U-Net 替换为 Transformer,通过 Patchify 将潜变量转换为 Token 序列,利用标准 Transformer Block 完成去噪,并验证 Transformer 的 Scaling 能力可以迁移到扩散模型
任务目标:ImageNet 类别条件图像生成
整体架构
传统扩散模型主要使用 U-Net 作为去噪网络,通过 Encoder-Decoder 和 Skip Connection 提取多尺度特征
DiT 则采用 ViT 的架构设计,在 LDM 的基础上,将二维 Latent Feature Map 转换为 Token 序列,再输入 Transformer 进行去噪
整体流程:
1 | Image |
Patchify
DiT 沿用 LDM 的潜空间扩散框架,使用预训练 VAE 将图像压缩到低维 Latent Space,扩散和去噪过程均在潜空间中进行
与 LDM 使用 U-Net 直接处理二维特征图不同,DiT 使用 Patchify 将 Latent Feature Map 划分为多个 Patch,并通过线性映射转换为 Token Embedding
假设输入 Latent 的空间尺寸为 $I\times I$,Patch Size 为 $p\times p$,则 Token 数量为:
Transformer 输出的 Token 最后经过线性映射和 Unpatchify,恢复为原始 Latent 的空间结构
Conditioning(条件注入)
扩散模型除了需要输入带噪 Latent,还需要知道当前时间步 $t$ 和生成条件 $y$
DiT 研究了四种条件注入方式:
| 方式 | 实现思路 | 特点 |
|---|---|---|
| In-Context Conditioning | 将条件 Embedding 作为额外 Token 拼接 | 直接使用标准 Transformer |
| Cross-Attention | 通过额外 Cross-Attention 注入条件 | 增加计算开销 |
| adaLN | 利用条件动态调节 LayerNorm | 不增加额外 Attention |
| adaLN-Zero | 在 adaLN 基础上增加零初始化的残差门控 | 有利于训练稳定性 |
首先将时间步 $t$ 和类别 $y$ 编码后相加($c$ 代表条件):

核心作用: 不需要额外增加 Cross-Attention,就能将时间步和类别条件动态注入 Transformer
Scaling
DiT 的另一项重要贡献是研究 Transformer 的 Scaling 能力能否迁移到扩散模型
论文主要研究两个变量:
- Model Size: 增加 Transformer 的深度和隐藏维度
- Patch Size: 减小 Patch Size,增加 Token 数量
实验发现:
增大 Transformer 规模,生成质量持续提升
减小 Patch Size,增加 Token 数量,也能够改善生成质量
模型计算量(GFlops)与生成质量存在明显关联,计算量增加通常伴随着 FID 下降
FID 越低,通常说明生成图像的整体质量和真实图像分布的接近程度越好
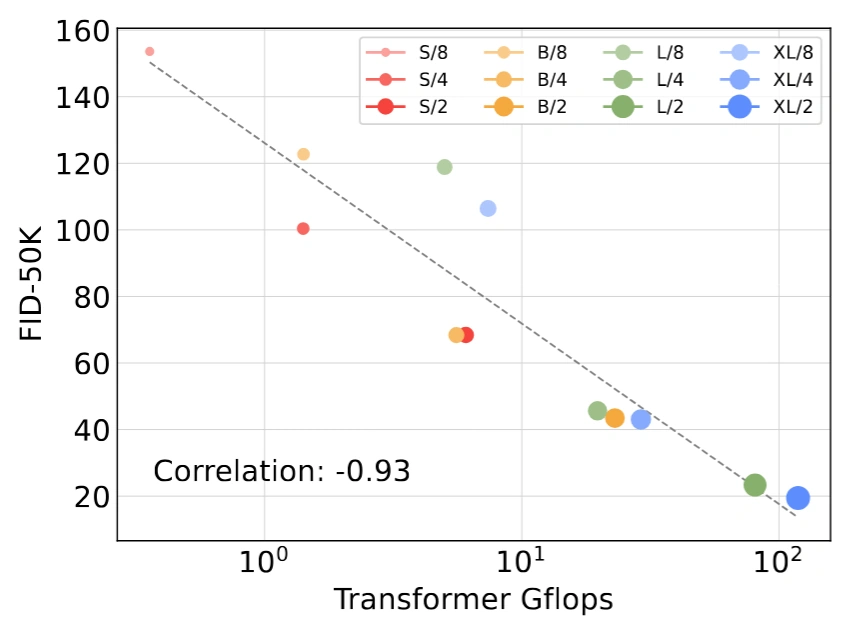
核心结论: Transformer 的 Scaling 能力同样适用于扩散模型,增加模型容量和计算量能够持续改善生成质量
PixArt-$\alpha$
核心思想: 基于 DiT 构建文本到图像生成模型,通过引入 Cross-Attention、优化条件调制结构,以及将训练过程拆分为不同阶段,在降低训练成本的同时实现高质量文本生成图像
整体架构
PixArt-α 沿用 DiT 的 Latent Diffusion 框架,主要包含三个部分:
- VAE: 将图像压缩为低维 Latent,使用预训练并冻结的 VAE
- Text Encoder: 使用 Flan-T5-XXL 提取文本特征
- DiT: 以 DiT-XL/2 为基础,在 Transformer Block 中加入 Cross-Attention,实现文本条件去噪
与原始 DiT 的类别条件生成不同,PixArt-α 将条件输入扩展为自然语言文本
Efficient T2I Transformer
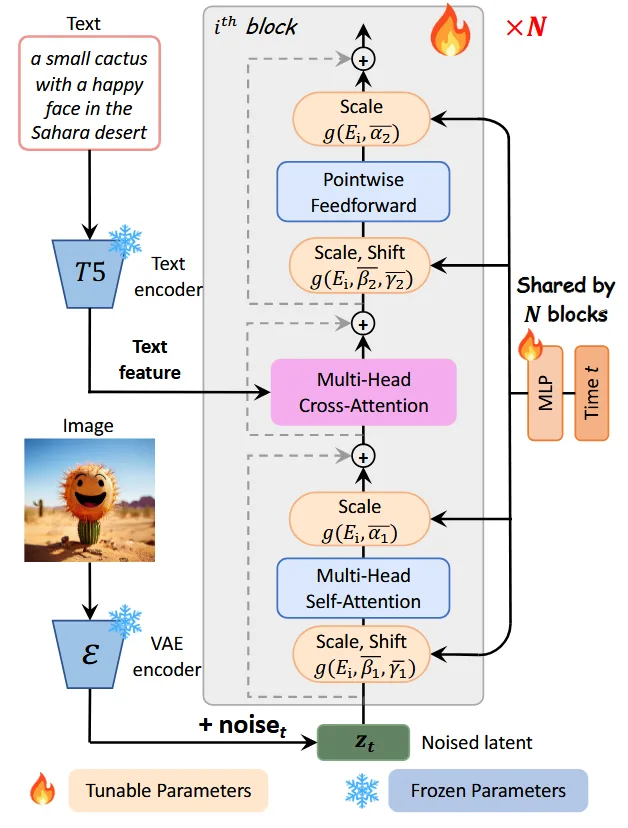
PixArt-α 对 DiT 的主要改进有两个
1. Cross-Attention
原始 DiT 主要通过 adaLN-Zero 注入时间步和类别条件,而文本生成需要处理更丰富的 Token-level 语义信息
因此 PixArt-α 在 Transformer Block 中增加 Cross-Attention
- Query:来自图像 Latent Token。
- Key、Value:来自 T5 文本特征
使图像 Token 能够动态关注不同文本 Token,实现细粒度的文本条件控制
为了保留预训练 DiT 的生成能力,Cross-Attention 的输出投影层采用零初始化,使其在训练初期近似恒等映射
2. adaLN-single
原始 DiT 的 adaLN 在每个 Transformer Block 中分别使用 MLP 生成条件调制参数,存在较多重复参数
PixArt-α 提出 adaLN-single:
- 使用一个共享 MLP,根据时间步生成全局调制参数
- 为不同 Transformer Block 引入独立的可学习 Layer Embedding
- 通过两者组合得到各层所需的调制参数
这样可以减少重复的条件映射参数,同时保留不同 Transformer Block 的特征调制能力
Training Strategy Decomposition
论文认为,文本生成图像实际上包含三个不同的学习任务:
- 学习自然图像的视觉分布
- 学习文本与图像之间的语义对齐
- 学习图像的审美质量
如果直接从头联合训练,需要大量数据和计算资源
因此,PixArt-α 将训练拆分为三个阶段:
Stage 1:Pixel Dependency Learning
- 使用 ImageNet 预训练类别条件 DiT
- 学习自然图像的视觉分布和像素依赖关系
- 为后续文本生成任务提供预训练权重初始化
Stage 2:Text-Image Alignment Learning
- 将类别条件模型转换为文本条件模型
- 引入 T5 文本编码器和 Cross-Attention
- 使用 SAM-LLaVA 生成的高信息密度图文数据进行训练
- 重点学习文本概念与图像内容之间的对应关系
Stage 3:High-resolution & Aesthetic Fine-tuning
- 使用高质量审美数据进行微调
- 引入多分辨率、多宽高比训练
- 提升高分辨率生成能力和图像审美质量
先建立基础表示能力,再学习不同模态之间的关联,最后针对目标任务进行能力强化
和多模态大模型的训练方法是类似的,特征对齐,再指令对齐
MMDIT
[2403.03206] Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
核心思想: 在 DiT 的基础上,为文本和图像两种模态分别设置独立的 Transformer 参数,并通过 Joint Attention 将两种模态的 Token 连接起来,实现双向信息交互
研究动机
DiT 主要面向 ImageNet 类别条件生成,通过 adaLN-Zero 将类别标签和时间步注入 Transformer
PixArt-α 将 DiT 扩展到文本生成图像,采用 Cross-Attention,这种方式本质上是图像特征主动查询文本特征,文本表示通常保持不变
但文本和图像属于不同模态,其特征分布和表示方式存在差异,直接共享 Transformer 参数,或者仅将文本作为外部条件,都可能限制两种模态的特征表达
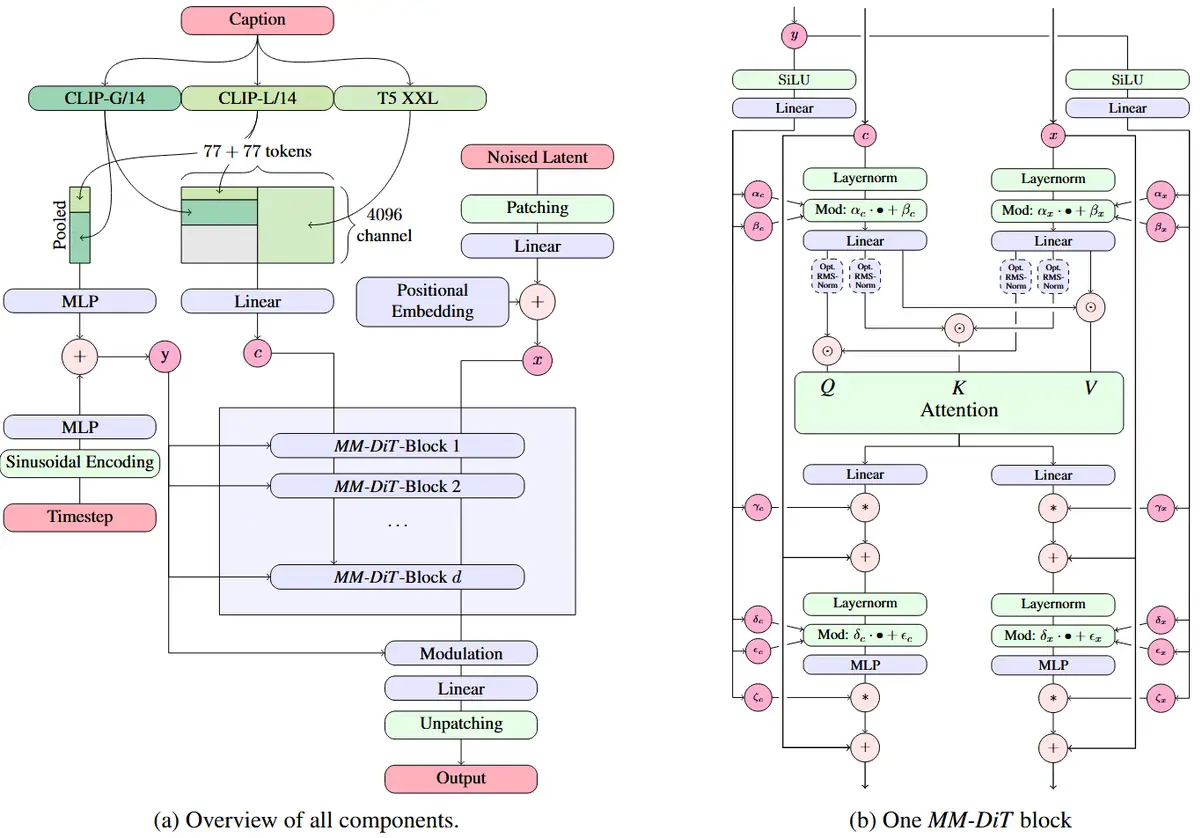
SD3 提出 MMDiT,让文本和图像拥有独立的参数化分支,同时通过联合 Attention 实现信息交互
MMDiT Architecture
MMDiT 主要包含两个独立的特征处理分支:
- Text Stream: 处理文本 Token,保留文本模态自身的特征表示
- Image Stream: 处理图像 Latent Token,学习视觉特征
两个分支分别拥有独立的参数,但在 Attention 阶段,两个分支的 Q、K、V 会被拼接起来,执行统一的 Joint Attention
Joint Attention
这是 MMDiT 最核心的设计
假设文本 Token 和图像 Token 分别为:
最后,将 Attention 输出按照原来的 Token 顺序拆分,分别返回文本和图像分支,继续执行各自的后续处理
Joint Attention 使两种模态能够同时进行:
- Image → Image:图像 Token 之间的信息交互
- Text → Text:文本 Token 之间的信息交互
- Image → Text:图像 Token 读取文本信息
- Text → Image:文本 Token 读取图像信息
避免不同模态完全共享同一套特征变换参数,同时建立更充分的文本与图像信息交互
Input
SD3 在 MMDiT 中使用三个预训练文本编码器:
- CLIP ViT-L/14
- CLIP ViT-G/14
- T5-XXL
CLIP 提供图文对齐的语义表示,T5 提供更丰富的自然语言特征
两个 CLIP 对同一个 Prompt 进行编码:
Training Objective
除了 MMDiT 架构,SD3 还将生成建模方式从传统 DDPM 扩展到 Rectified Flow
DDPM 主要学习预测加入数据中的噪声,而 Rectified Flow 学习的是从噪声分布到数据分布的速度场,具体见Flow Matching