视觉表征与多模态
视觉 Backbone
ResNet 通过残差连接改善深层网络的优化问题,使网络能够在增加深度的同时持续获得性能提升,成为后续视觉 Backbone 的重要基础
VIT
[2010.11929] An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
核心思想:将图像划分为多个固定大小的 Patch,把每个 Patch 看作 NLP 中的一个 Token,通过 线性映射为固定维度的 Patch Embedding,再直接输入标准 Transformer Encoder,实现图像的序列建模
1 | Image |
Patch Embedding
将输入图像划分为互不重叠的 $P\times P$ Patch,每个 Patch 展平后通过线性层映射到固定维度 $D$
每个 Patch 就对应 Transformer 中的一个 token
Position Embedding
原始 ViT 延续 BERT 的设计
- CLS Token:在 Patch Tokens 前加入一个可学习的
[CLS]Token,用于聚合全局图像信息,最终用于分类 - Position Embedding:为每个 Token 添加可学习的一维位置编码,保留 Patch 的位置信息
输入序列:
Transformer Encoder
1 | Input Image |
核心特点与局限
特点:
- 将视觉任务转化为序列建模问题,直接利用 Transformer 的 Self-Attention 建模全局关系
- 不再依赖 CNN 的局部卷积结构,可以统一处理不同 Patch 之间的信息交互
局限:
- Global Self-Attention 的计算复杂度随 Token 数量呈平方增长,处理高分辨率图像时计算和显存开销较大
- 缺少 CNN 的层次化特征结构,不利于直接适配检测、分割等需要多尺度特征的任务
Swin Transformer
[2103.14030] Swin Transformer: Hierarchical Vision Transformer using Shifted Windows
核心思想:通过三个核心设计解决VIT的问题
- Window Attention:降低全局 Self-Attention 的计算开销
- Shifted Window:实现跨窗口信息交互
- Patch Merging:构建层次化特征结构
Patch Embedding
Swin 保留图像的二维空间结构,而不是像 ViT 一样直接将图像作为一维序列处理
原论文使用 $P=4$,将输入图像划分为二维网格,再通过 Linear Projection 映射到特征维度
1 | Input |
每个 $4\times4\times3$ 的 Patch 被展平成一个长度为 48 的向量
实现空间下采样
Window Attention
Swin 将特征图划分为多个固定大小的 Window,只在每个 Window 内部执行 Self-Attention
原论文默认窗口大小为 ($7\times7$)
1 | [B, 56, 56, 96] |
每张图有 64 个 window,每个 window 有 49 个 token,每个 token 是 96 维
将 Window 合并到 Batch 维度后,各窗口可以独立执行 Attention,显著降低计算量
Shifted Window
Window Attention 存在一个问题:不同 Window 之间无法直接进行信息交互
因此,Swin 引入 Shifted Window:在下一层将窗口划分整体平移,使原本属于不同窗口的 Token 能够进入同一个窗口,从而实现跨窗口信息传递
- W-MSA:Window Multi-head Self-Attention,负责窗口内部的信息交互
- SW-MSA:Shifted Window Multi-head Self-Attention,负责跨窗口的信息交互
连续两个 Swin Block 交替使用 W-MSA 和 SW-MSA
1 | 原窗口 |
实现跨 Window 信息交流
Patch Merging
为了构建类似 CNN 的层次化特征结构,Swin 引入 Patch Merging,逐层降低空间分辨率,同时增加特征维度
具体过程:
- 将相邻 $2\times2$ 的四个 Token 在 Channel 维度拼接。
- 通过 Linear Projection 将维度从 $4C$ 降至 $2C$
1 | 特征图 |
最终形成多阶段特征金字塔,使模型能够提取不同空间尺度的视觉特征
相对位置偏置
Swin 在 Attention 中引入 Relative Position Bias(相对位置偏置),将 Token 之间的相对空间位置关系加入 Attention 计算
ConvNeXt
核心思想:以 ResNet 为基础,引入 Transformer 时代的设计思想,对传统 CNN 进行现代化改造,使纯 CNN 获得与 Swin Transformer 相近的性能
Depthwise Convolution
传统卷积同时完成:
- Spatial Mixing:融合邻域空间信息
- Channel Mixing:融合不同通道的信息
ConvNeXt 将两种操作显式拆开
- Depthwise Conv:每个 Channel 独立进行空间卷积,提取局部空间特征
- 1 × 1 Conv:融合不同 Channel 的信息
从参数量上来看:
普通卷积
$$ Params=K^2C_{in}C_{out} $$Group Conv (分组 $G = Cardinality$)
$$ \mathrm{Params}=\frac{K^2C_{in}C_{out}}{G} $$Depthwise Conv 可以看作 $G=C_{\text{in}}$,并且通常 $C_{\text{out}}=C_{\text{in}}$
$$ Params=K^2C_{in} $$
相比普通卷积,Depthwise Conv 参数量和计算量更低,因此 ConvNeXt 使用较大的 $7\times7$ 卷积核,在较低计算开销下扩大感受野
Inverted Bottleneck
传统 ResNet Bottleneck 采用先降维、再进行空间卷积、最后升维的结构
ConvNeXt 则采用类似 Transformer FFN 的 Inverted Bottleneck
1 | Input C |
先升维,再进行非线性变换,最后降维,增强 Channel Mixing 能力
网络结构
采用类似 Swin Transformer 的四阶段层次化结构

ConvNeXt 并没有引入 Transformer,而是通过 Depthwise Conv、Inverted Bottleneck、LayerNorm 等现代化设计,重新构建纯 CNN 架构
证明传统 CNN 经过现代化改造后,依然能够达到与视觉 Transformer 相近的性能
自监督视觉表征
MAE
[2111.06377] Masked Autoencoders Are Scalable Vision Learners
核心思想:将图像随机划分为 Patch,并 Mask 掉大部分 Patch,让模型根据剩余可见区域重建原始图像,通过重建任务学习通用视觉表征,减少对人工标注数据的依赖
Masking Strategy
MAE 在输入阶段随机 Mask 大部分图像 Patch:
- 将图像划分为固定大小的 Patch。
- 随机选择一部分 Patch 保留,其余 Patch 被 Mask。
- 默认 Masking Ratio 为 75%,即只保留 25% 的可见 Patch。
高比例 Masking 可以减少图像中的冗余信息,使模型必须利用有限的可见区域理解整体图像结构
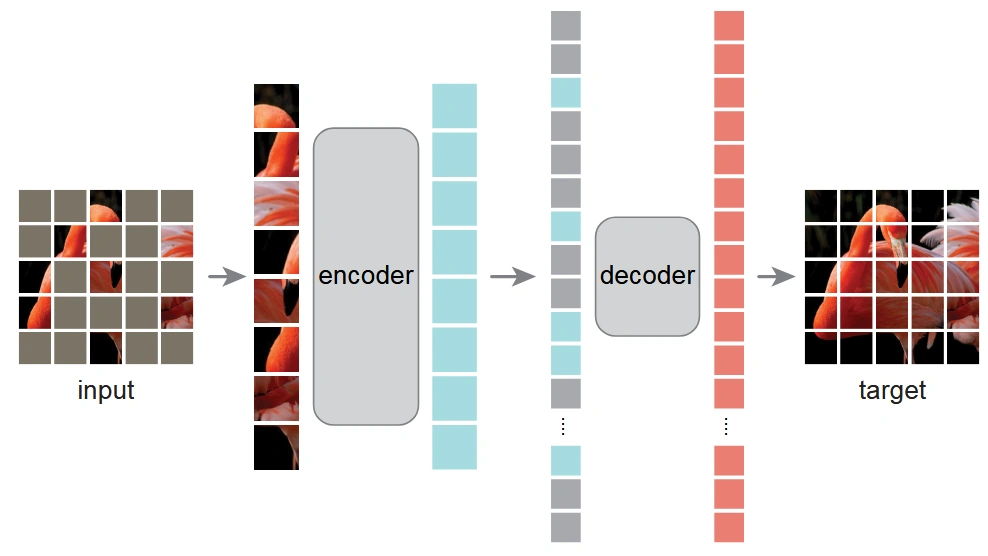
Asymmetric Encoder-Decoder
MAE 最重要的设计是非对称 Encoder-Decoder 架构
Encoder
- 使用标准 ViT 作为视觉编码器
- 只处理可见 Patch,不输入 Mask Token
- 提取可见区域的视觉特征
Decoder
- 将 Encoder 输出与 Mask Token 组合,恢复完整 Token 序列
- 使用轻量级 Transformer Decoder 重建原始图像
- 预测每个 Patch 的像素值
核心设计: 计算量较大的 Encoder 只处理可见 Patch,而 Decoder 相对轻量,因此能够显著降低预训练成本
论文报告,这种设计可以实现 3 倍以上的训练加速
Reconstruction Loss
MAE 直接以原始图像 Patch 的像素值作为重建目标,使用 MSE Loss,仅在被 Mask 的 Patch 上计算损失:
下游任务直接使用 Encoder 提取视觉特征
可以通过 Fine-tuning 适配图像分类、目标检测等任务
DINOv2
[2304.07193] DINOv2: Learning Robust Visual Features without Supervision
核心思想: 基于 ViT,通过 Teacher-Student 自蒸馏学习通用视觉表征,结合图像级和 Patch 级自监督目标,并利用大规模高质量数据训练,使模型具备较强的语义理解、局部特征提取和跨任务迁移能力
Teacher-Student 架构
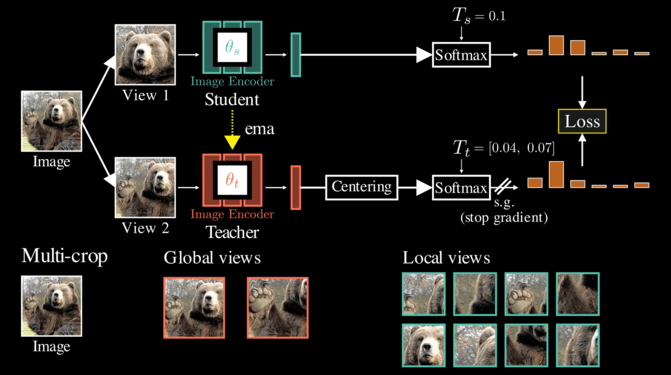
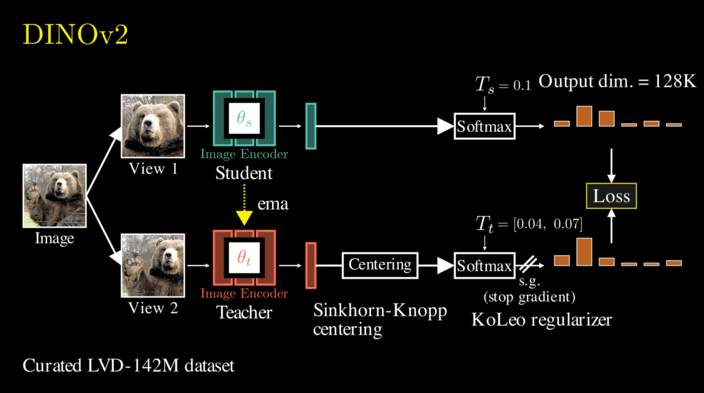
DINOv2 使用两个结构相同的 ViT 网络
Student Network:接收图像并通过反向传播更新参数
Teacher Network:生成学习目标,不参与反向传播,通过 Student 参数的 EMA(Exponential Moving Average)更新
Teacher 的参数更新方式:
$$ \theta_t \leftarrow m\theta_t+(1-m)\theta_s $$
训练时,Teacher 主要接收完整的 Global Views,Student 接收 Global Views 和 Local Views,并对部分输入 Patch 进行 Mask

随着训练推进,Teacher 的更新通常越来越平缓
训练结束后通常选择 Teacher 作为最终模型
联合训练目标
DINOv2 将 DINO 和 iBOT 两种自监督方法结合,同时学习图像级和 Patch 级视觉表征
1. DINO:Image-level Learning
[2104.14294] Emerging Properties in Self-Supervised Vision Transformers
比较 Teacher 和 Student 的 CLS Token 输出
- Teacher:提取 Global View 的全局图像特征。
- Student:提取不同视图的图像特征。
- 经过 Projection Head 后得到概率分布,使用 Cross-Entropy Loss 让 Student 的输出接近 Teacher
核心作用: 通过 CLS Token 学习全局图像语义
2. iBOT:Patch-level Learning
[2111.07832] iBOT: Image BERT Pre-Training with Online Tokenizer
这部分和 MAE 相似
在 Student 输入中随机 Mask 部分 Patch,而 Teacher 看到完整图像,不进行 Mask
- Teacher:提取完整图像的 Patch Features
- Student:提取特征后,取出被 Mask 位置对应的 Patch Token
- 计算对应位置 Teacher 和 Student 输出分布之间的 Cross-Entropy Loss
核心作用: 通过 Patch Token 学习局部视觉特征
与 MAE 的区别:
- MAE:预测被 Mask 区域的原始像素
- iBOT:预测 Teacher 对应位置的特征分布
关键改进
Sinkhorn-Knopp(SK)归一化
Teacher 使用 Sinkhorn-Knopp 算法生成相对均衡的 Prototype 分配,Student 使用标准 Softmax 生成预测分布。
有点类似MoE的目的,避免只有一个专家在用
通过交替进行行、列归一化,使 Batch 内样本在不同 Prototype 之间获得相对均衡的分配,缓解特征坍塌
KoLeo Regularization(特征分散正则化)
KoLeo 基于最近邻距离约束特征分布,鼓励 Batch 内不同图像的特征在表示空间中更加均匀地分散
通过增大特征与最近邻特征之间的距离,减少特征过度聚集,提升特征多样性,对图像检索等任务尤其有帮助
Untied Projection Heads
DINO 和 iBOT 分别使用独立的 Projection Head,避免图像级和 Patch 级训练目标之间产生干扰,使模型能够更好地学习不同层次的视觉表征
视觉语言预训练(VLP)
双塔式视觉语言对齐
CLIP
[2103.00020] Learning Transferable Visual Models From Natural Language Supervision
核心思想:利用大规模图文配对数据,同时训练 Image Encoder 和 Text Encoder,将图像与文本映射到同一个语义空间,通过对比学习使匹配的图文表示靠近、不匹配的图文表示远离,从而实现跨模态语义对齐和 Zero-shot 分类
模型结构
CLIP 采用双编码器架构(双塔架构):
- Image Encoder:使用 CNN(ResNet)或 ViT 提取图像特征
- Text Encoder:使用 Transformer 提取文本特征
两个 Encoder 分别通过 Projection Layer 将特征映射到相同维度的共享语义空间
1 | CLIP |
对比学习
训练数据由大量匹配的 (image, text) Pair 构成
一个 Batch 中
分别提取图像和文本特征,并进行 L2 归一化,再计算余弦相似度:
通过对比学习,使匹配的图文特征相似度增大,不匹配的图文特征相似度降低
Similarity 在进入 Softmax 前还会经过缩放
训练时同时优化两个方向:
Image → Text
给定一张图片 $I_i$,在 batch 中所有文本里找到与它匹配的 $T_i$:
Text → Image
给定文本 $ T_i$,在所有图片中找到 $ I_i$:
最终

Zero-shot 分类
CLIP 最重要的能力是 Zero-shot 分类:不需要针对新的分类任务重新训练模型,就能够识别未见过的类别
具体过程:
- 将类别名称构造成自然语言 Prompt,例如
A photo of a dog - 使用 Text Encoder 提取各类别的文本特征
- 使用 Image Encoder 提取待分类图像的特征
- 计算图像与各类别文本特征的相似度
- 选择相似度最高的文本类别作为预测结果
这些 Text Embedding 就可以看成 Classification Weight
Text Encoder 可以理解为根据自然语言动态生成 Linear Classifier 的权重
SigLIP
核心思想:在 CLIP 双编码器架构的基础上,将 Softmax Contrastive Loss 替换为 Pairwise Sigmoid Loss,将图文匹配转化为独立的二分类任务,降低对 Batch 内全局归一化的依赖,提高训练效率
Sigmoid Loss
CLIP 将图文匹配看作双向 N 分类问题,而 SigLIP 将每一个 Image-Text Pair 看作独立的二分类问题
对于一个 Batch:
- 对角线上的 $N$ 个 Pair 是 Positive Pair,标签为 $+1$
- 其余 Pair 是 Negative Pair,标签为 $-1$
分别提取图像和文本特征,并进行 L2 归一化,计算相似度:
一个 Batch 中负样本数量远多于正样本,训练初期容易受到负样本主导,产生较大的优化步长
因此引入可学习 Bias,初始化为 $-10$,Logit Scale 初始化为 $10$,使模型初始预测更符合正负样本比例,减少训练初期的过度修正
Chunked Implementation
由于 Sigmoid Loss 中每个 Pair 的损失可以独立计算,因此可以将 $N\times N$ 的 Similarity Matrix 拆分成多个小块(Chunk)进行计算
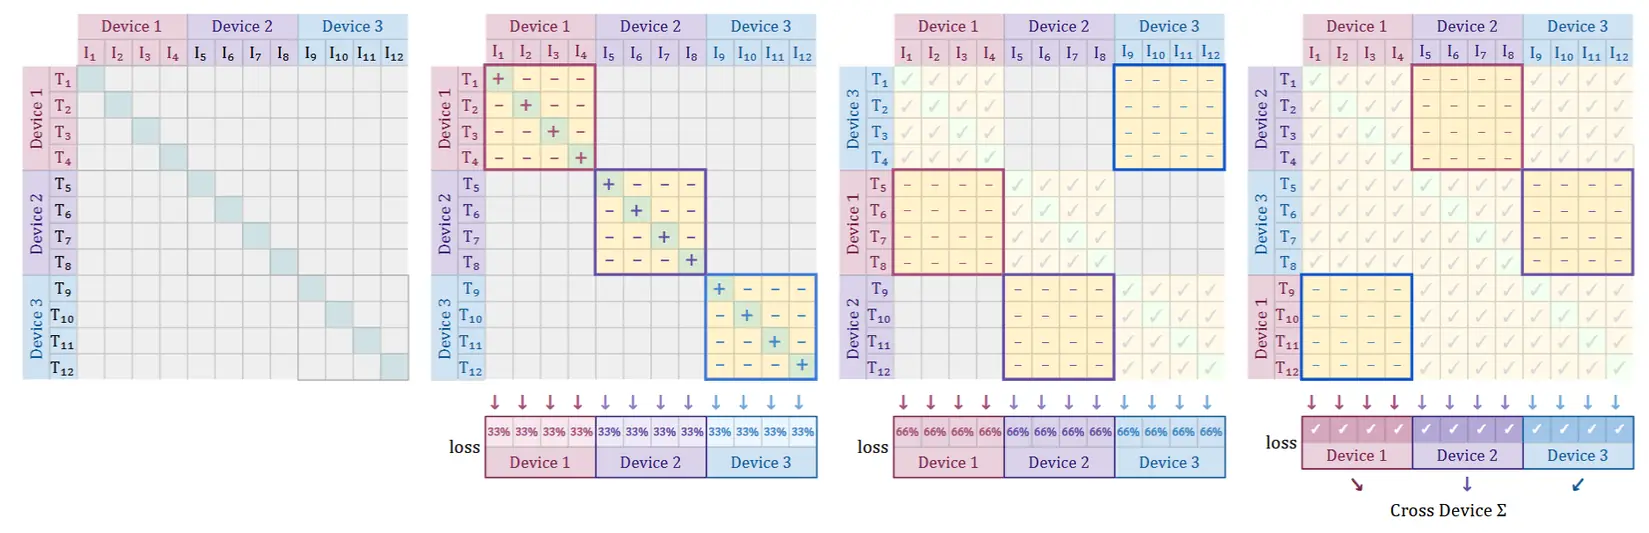
不需要一次性构造完整的全局 Similarity Matrix,可以逐块计算并累积 Loss,从而降低峰值显存占用和分布式通信开销
但是仍然需要考虑 Batch 内的正负样本组合,并没有消除 $N^2$ 级别的图文匹配关系
SigLIP-2
核心思想: 在 SigLIP 双塔架构的基础上,引入图像描述、自蒸馏和 Masked Prediction 等训练目标,增强模型的全局语义理解、局部视觉表征、空间定位和多语言理解能力
Captioning-based Pretraining
在原有 Image Encoder 和 Text Encoder 的基础上,增加 Transformer Decoder,通过 Cross-Attention 融合视觉特征,增加三个训练任务:
- Image Captioning:根据图像生成整体描述,学习图像与自然语言之间的语义关联
- Referring Expression Prediction:根据文本描述预测对应物体的 Bounding Box
- Grounded Captioning:给定 Bounding Box,生成对应图像区域的描述

借鉴 LocCa,通过图像描述和区域定位任务,让视觉 Encoder 学习更丰富的局部语义和空间信息
多阶段训练
采用两阶段训练策略:
Stage 1:图文对齐与生成任务
前 80% 的训练过程中,联合优化:
- Sigmoid Loss:保留原有图文对齐能力。
- LocCa Decoder Loss:通过图像描述和区域定位增强视觉特征
Stage 2:引入自监督目标
训练达到 80% 后,额外引入两个训练目标:
1. Self-Distillation
借鉴 DINO 系列的 Teacher-Student 自蒸馏思想:
- Teacher:接收完整的 Global View,提取全局视觉特征
- Student:接收 8 个 Local Views,提取局部视觉特征
- 通过特征一致性 Loss,让 Student 的局部特征匹配 Teacher 的全局特征
- Teacher 参数通过 Student 参数的 EMA 更新
核心作用: 增强全局与局部视觉特征之间的语义一致性
2. Masked Prediction
借鉴 MAE 的 Masked Prediction 思想,让 Student 预测被 Mask 区域对应的 Teacher Features:
- Teacher:接收完整图像,提取所有 Patch Features
- Student:随机 Mask 50% 的 Patch
- 训练目标:预测被 Mask 位置对应的 Teacher Patch Features
核心作用: 增强 Patch-level Representation,学习更丰富的局部视觉信息
训练完成后移除辅助 Decoder,仅保留 Image Encoder 和 Text Encoder
NaFlex
传统 ViT 通常需要将输入图像 Resize 到固定尺寸,可能造成图像宽高比失真和细节丢失
NaFlex 融合了两个思路:
FlexiViT:支持不同的预设 Patch 序列长度,使模型能够适应不同分辨率
训练时随机选择 Patch Size,动态调整 Patch Embedding 和 Position Embedding
同一套模型参数就能处理不同 Patch Size 的输入
NaViT:支持原生宽高比
[2307.06304] Patch n' Pack: NaViT, a Vision Transformer for any Aspect Ratio and Resolution
不再强制将所有图像 Resize 到固定的正方形尺寸,而是尽可能保留图像原始宽高比,并允许不同图像产生不同数量的 Patch Token
与 BLIP-2 的区别: BLIP-2 通过 Q-Former 将视觉信息提取并传递给 LLM;SigLIP-2 则利用辅助训练任务增强视觉语言 Encoder 本身的表征能力
跨模态对齐与融合
ALBEF
核心思想: 先通过对比学习对齐图像和文本的全局语义特征,再通过 Cross-Attention 进行跨模态融合,同时引入 Momentum Distillation,利用动量模型生成软标签,缓解 Web 图文数据中的噪声问题
模型架构
ALBEF 采用三个 Encoder 构成的架构:
- Image Encoder:使用 ViT-B/16 提取图像 Patch Features
- Text Encoder:使用 Transformer 提取文本 Token Features
- Multimodal Encoder:通过 Cross-Attention 融合图像和文本特征,学习细粒度跨模态关系
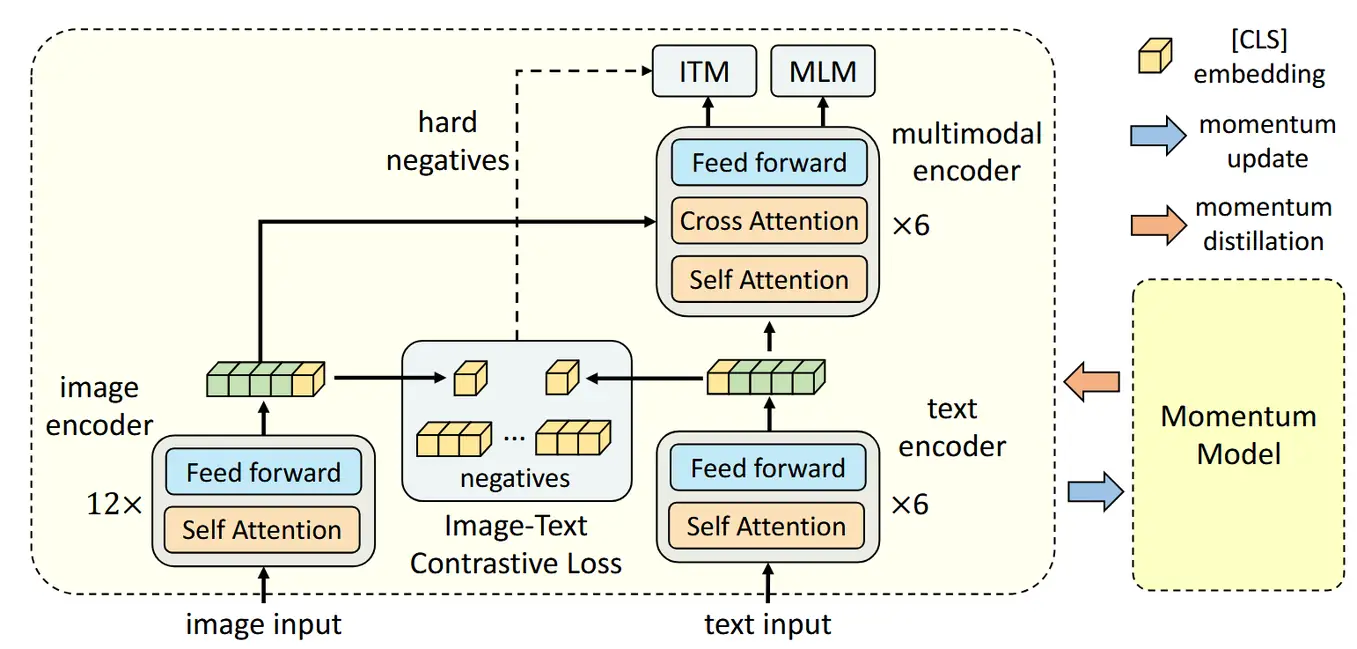
Image Encoder 和 Text Encoder 独立提取特征,Multimodal Encoder 接收两者的输出进行跨模态交互
与 CLIP 的区别:
- CLIP:通过双塔结构进行图文对齐,不进行深层跨模态特征交互
- ALBEF:先通过双塔结构对齐图文特征,再通过 Multimodal Encoder 进行融合
Align Before Fuse
ALBEF 最重要的设计是先对齐、再融合
第一步:Alignment
使用 Image Encoder 和 Text Encoder 分别提取图像和文本的全局特征,通过 Image-Text Contrastive Loss(ITC)将匹配的图文特征拉近,不匹配的特征推远
第二步:Fusion
将两个 Encoder 输出的 Token Features 输入 Multimodal Encoder,通过 Cross-Attention 实现跨模态信息交互
先完成全局语义对齐,可以降低不同模态之间的特征差异,使后续 Cross-Attention 更容易学习细粒度的跨模态关系
联合训练目标
ALBEF 联合优化三个训练目标:
| Loss | 核心作用 |
|---|---|
| ITC | 图文全局语义对齐,类似 CLIP |
| MLM | 根据图像和上下文预测被 Mask 的文本 Token |
| ITM | 判断图像与文本是否匹配,学习细粒度跨模态关系 |
MLM(Masked Language Modeling)
随机 Mask 15% 的文本 Token,将图像特征和剩余文本输入 Multimodal Encoder,预测被 Mask 的 Token
通过视觉信息辅助文本预测,让模型学习图像与文本之间的细粒度语义关联
ITM(Image-Text Matching)
判断输入的图像和文本是否匹配,使用 Multimodal Encoder 输出的 CLS Token 作为联合特征,通过 FC Layer 和 Softmax 完成二分类
ALBEF 使用 Online Hard Negative Mining:
根据 ITC 计算的图文相似度,从 Batch 中采样语义相似但实际不匹配的图文 Pair,让模型学习更加细粒度的跨模态差异
最终联合训练目标:
Momentum Distillation
Web 图文数据通常存在噪声:
- 一张图片可能包含文本没有描述的物体。
- 文本可能包含与图片无关的信息。
- 同一张图片可能存在多个合理的文本描述。
传统训练使用 One-hot Label,将标注之外的预测全部视为错误,容易受到噪声标注的影响
因此 ALBEF 引入 Momentum Distillation(MoD),利用动量模型生成 Soft Targets,为 Student 提供额外监督
参考DINOv2的Teacher-Student 架构
维护两个模型:
- Student:正常参与反向传播,更新模型参数
- Teacher:不参与反向传播,通过 Student 参数的 EMA 更新
Teacher 根据当前图文输入生成概率分布,作为 Student 的软标签
Student 同时学习原始标注和 Teacher 生成的 Soft Targets
允许模型学习标注之外的合理语义信息,降低噪声图文数据对模型训练的负面影响
跨模态交互与生成
BLIP
核心思想: 在视觉语言预训练中,通过 MED 统一图文理解与文本生成,并利用 CapFilt 自动生成和过滤图文描述,改善 Web 图文数据的质量
MED(Multimodal Mixture of Encoder-Decoder)
传统视觉语言模型通常存在两种设计:
- Encoder-based:擅长图文检索、匹配等理解任务,但不擅长文本生成
- Encoder-Decoder:擅长文本生成,但图文理解和检索能力相对受限
BLIP 提出 MED,让同一个预训练框架支持三种模式:
| 模式 | 主要结构 | 作用 |
|---|---|---|
| Unimodal Encoder | Image Encoder + Text Encoder | 独立提取图文特征 |
| Image-grounded Text Encoder | Text Encoder + Cross-Attention | 融合图文特征,判断是否匹配 |
| Image-grounded Text Decoder | Text Decoder + Cross-Attention | 基于图像自回归生成文本 |

核心模块:
- Image Encoder:使用 ViT 提取图像 Patch Features
- Text Encoder:使用双向 Self-Attention 获取文本表示,并通过 Cross-Attention 融合图像特征
- Text Decoder:使用 Causal Self-Attention,根据图像特征逐 Token 生成文本
Text Encoder 和 Text Decoder 共享除 Self-Attention 外的参数,包括 Embedding、Cross-Attention 和 FFN
原因是理解任务需要双向上下文,而生成任务需要因果掩码,两者对 Self-Attention 的要求不同
训练目标
BLIP 联合优化两个理解任务目标和一个生成任务目标
三个目标分别对应 MED 的不同工作模式:
- ITC:使用 Unimodal Encoder,通过对比学习对齐图像与文本特征
- ITM:使用 Image-grounded Text Encoder,通过 Cross-Attention 融合图文特征,判断图文是否匹配
- LM:使用 Image-grounded Text Decoder,根据视觉特征预测下一个 Token,生成图像描述
通过三个目标联合训练,使模型同时具备图文对齐、跨模态理解和文本生成能力
CapFilt(Captioning and Filtering)
BLIP 不完全依赖原始 Web Text,因为其中存在较多与图像内容不匹配的噪声文本
因此提出 CapFilt,通过 Captioner 生成描述,再利用 Filter 筛选高质量图文数据

两个核心模块:
- Captioner:由 Image-grounded Text Decoder 初始化,根据图像生成新的文本描述
- Filter:由 Image-grounded Text Encoder 初始化,通过 ITC 和 ITM 判断图文是否匹配
具体过程:
- Pretraining:利用原始 Web 图文数据和人工标注数据预训练 MED
- Captioner & Filter:利用 COCO 人工标注数据微调两个模块
- Data Bootstrapping:
- Captioner 为原始 Web 图片生成 Synthetic Captions
- Filter 分别判断原始 Web Text 和生成描述是否与图像匹配
- 过滤低质量图文对,保留高质量的原始描述和生成描述
- 将筛选后的 Web 图文数据与人工标注数据合并,重新预训练 MED
核心思想:利用模型自身的能力改善训练数据,再利用改善后的数据提升模型能力
BLIP-2
核心思想: 利用预训练的视觉编码器和大语言模型,通过轻量级 Q-Former 连接两个模态,并采用两阶段训练实现视觉特征与语言模型的高效对齐
Q-Former
BLIP-2 希望直接利用已经训练好的单模态模型:
- Image Encoder:预训练视觉编码器,提供高质量视觉特征
- LLM:预训练大语言模型,提供语言理解与生成能力
由于两个模型分别在不同模态上训练,特征空间并不天然对齐,因此引入 Q-Former 作为中间连接模块
Q-Former 引入 32 个可学习的 Query,通过 Cross-Attention 与冻结视觉编码器的输出交互,主动提取与语言任务相关的视觉信息

每个 Query 随着训练进行,会学习如何从视觉特征中提取对图文任务有用的信息
论文给出的 ViT-L/14 视觉特征形状是 257 × 1024,而 Q-Former 输出为 32 × 768
Q-Former 起到 Information Bottleneck 的作用,将较长的视觉特征序列压缩成固定数量的 Query Features,过滤冗余视觉信息
与 BLIP 的区别:
- BLIP:主要通过 Text Token 的 Cross-Attention 读取视觉特征
- BLIP-2:引入可学习 Query,主动从视觉特征中提取信息
两阶段预训练
第一阶段:Vision-Language Representation Learning
冻结 Image Encoder,训练 Q-Former,使 Query 能够提取与文本语义相关的视觉特征
借鉴 BLIP,联合使用三个训练目标:
| Loss | 核心作用 |
|---|---|
| ITC | 图文全局特征对齐 |
| ITM | 判断图文是否匹配,学习细粒度跨模态关系 |
| ITG | 根据图像特征自回归生成文本 |
三个任务通过不同的 Self-Attention Mask 控制 Query 和 Text Token 之间的信息交互
第二阶段:Vision-to-Language Generative Learning
将预训练好的 Q-Former 接入冻结的 LLM,使视觉特征能够被语言模型理解并用于文本生成
具体过程:
- Q-Former 提取 32 个 Query Features
- 通过 FC Layer 将特征映射到 LLM 的词嵌入维度
- 将投影后的视觉特征作为 Soft Visual Prompts,拼接到文本 Embedding 前面
- 使用文本生成 Loss 训练 Q-Former 和投影层,Image Encoder 与 LLM 保持冻结
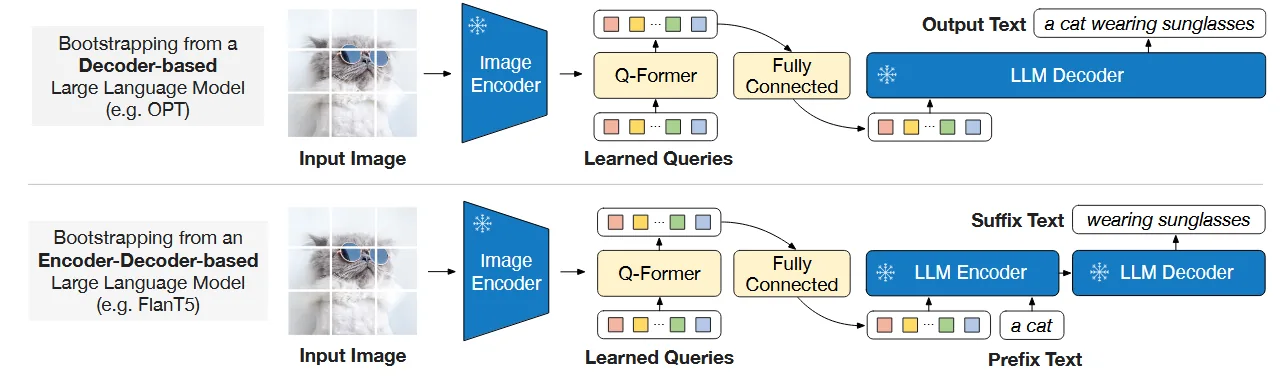
这里的两种模式其实是针对两种不同架构的LLM
BLIP-2 的核心:冻结预训练的视觉编码器和 LLM,仅训练 Q-Former 等轻量级跨模态连接模块,实现视觉信息向语言模型的迁移,同时保留两个单模态模型原有的能力
多模态大模型
LLaVA
核心思想: 通过简单的视觉投影层连接预训练视觉编码器与 LLM,并利用多模态指令微调,使大语言模型能够根据图像和用户指令生成回答
模型架构
与 BLIP-2 相比,LLaVA 采用相对简单的视觉连接结构,包含三个核心模块:
- Vision Encoder:使用预训练的 CLIP ViT-L/14,提取图像 Patch Features
- Projection Layer:使用 Linear Projection,将视觉特征映射到 LLM 的词嵌入维度
- LLM:接收视觉特征和文本指令,自回归生成回答
与 BLIP-2 的区别:
- BLIP-2:通过 Q-Former 和 Cross-Attention 主动提取、压缩视觉信息
- LLaVA:直接保留视觉 Patch Features,通过线性映射接入 LLM
多模态指令数据构建
普通图文数据通常只有 Image-Text Pair:Image → Caption
1 | Image: 一辆停在车库里的 SUV |
但这种数据主要提供图像描述,无法充分训练模型理解不同用户指令并组织回答。
LLaVA 将训练形式扩展为:Image + Instruction → Response

使模型能够学习:
- 图像内容描述
- 根据问题理解图像
- 结合视觉信息进行推理
两阶段训练
LLaVA 采用两阶段训练,分别完成视觉特征对齐和视觉指令微调
第一阶段:Feature Alignment(特征对齐)
在冻结 Vision Encoder 和 LLM 的情况下,仅训练 Linear Projection,使视觉特征映射到 LLM 的词嵌入空间
原论文将这个阶段理解为训练一个与冻结 LLM 兼容的 Visual Tokenizer
第二阶段:Visual Instruction Tuning(视觉指令微调)
不仅要让 LLM 接收视觉信息,还要让它根据不同用户指令利用这些视觉信息
与第一阶段不同:
- Vision Encoder:保持冻结
- Projection Layer:继续训练
- LLM:解冻并参与训练
Qwen2-VL
[2409.12191] Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution
核心思想: 通过动态分辨率、M-RoPE 和图像视频统一建模,增强模型对不同尺度图像及视频时空信息的感知能力
模型架构
Qwen2-VL 延续 Vision Encoder + Connector + LLM 的基本架构:
- Vision Encoder:使用 ViT 提取图像和视频的视觉特征
- MLP Connector:将相邻的 2×2 Visual Tokens 合并,并映射到 LLM 的特征维度
- LLM:使用 Qwen2 作为语言模型,接收视觉 Token 和文本 Token,进行统一的多模态建模
Naive Dynamic Resolution
传统视觉模型通常将输入图像 Resize 到固定分辨率,容易造成高分辨率图像的细节丢失和宽高比失真
Qwen2-VL 引入 Naive Dynamic Resolution,根据输入图像的分辨率和宽高比,动态生成不同数量的 Visual Tokens
主要设计:
移除 ViT 原有的绝对位置编码,引入 2D-RoPE,表示图像 Patch 的二维空间位置
根据图像分辨率动态生成不同数量的 Patch Tokens
使用 MLP 将相邻 2×2 Visual Tokens 合并为一个 Token,降低视觉序列长度
以 224×224 图像为例(Patch Size = 14):
- Patchify:产生 16×16 = 256 个 Patch Tokens
- 2×2 Merge:得到 8×8 = 64 个 Visual Tokens
- 加上
<|vision_start|>和<|vision_end|>,共 66 个 Token
核心: 保留图像原始宽高比,根据分辨率动态调整视觉 Token 数量,在视觉细节与计算开销之间取得平衡
M-RoPE
传统 RoPE 主要表示一维序列位置,难以直接描述图像和视频的空间、时间关系
Qwen2-VL 将位置编码拆分为三个维度:
- Temporal:时间维度 $T$
- Height:高度维度 $H$
- Width:宽度维度 $W$
不同模态的位置编码方式:
| 模态 | 位置编码方式 |
|---|---|
| Text | 三个维度使用相同的位置 ID,等价于 1D-RoPE |
| Image | T 固定,H、W 分别表示 Patch 的二维位置 |
| Video | T 随 Frame 变化,H、W 表示帧内空间位置 |
这样可以在统一的序列中表示文本、图像和视频的位置信息
当模型输入包含多种模态时,每个模态的位置编号从前一个模态的最大位置 ID 加 1 开始
图像视频的统一建模
将图像和视频放在统一的视觉处理框架中进行训练,使模型同时学习静态视觉理解与动态视频理解
- Video:引入深度为 2 的 3D Convolution,将相邻两帧的对应空间区域编码为时空 Patch,减少视频 Token 数量
- Image:将静态图像视为两张相同的帧,使用相同的处理方式
视频按照 2 FPS 采样,并动态调整分辨率,将单个视频的视觉 Token 数量限制在 16384 以内
三阶段训练
Qwen2-VL 采用三阶段训练策略:
| 阶段 | Vision Encoder | LLM | 训练目标 |
|---|---|---|---|
| Stage 1 | 训练 | 冻结 | 视觉语义学习 |
| Stage 2 | 训练 | 训练 | 多模态联合学习 |
| Stage 3 | 冻结 | 训练 | 多模态指令微调 |
- Stage 1:使用大规模 Image-Text Pairs 训练 ViT,学习视觉语义与文本之间的关联
- Stage 2:解冻全部参数,使用图文、视频、VQA 等混合数据进行多模态预训练
- Stage 3:冻结 ViT,使用多模态指令数据微调 LLM,增强指令理解与生成能力
Visual Grounding
通过特殊 Token 将文本描述与图像中的具体区域关联起来:
| 标记 | 作用 |
|---|---|
| `< | vision_start |
| `< | im_start |
| `< | object_ref_start |
| `< | box_start |
Bounding Box 坐标归一化到 [0, 1000),并作为文本序列的一部分进行预测
使模型不仅能够描述图像中的物体,还能够输出对应物体的位置
Qwen2.5-VL
核心思想: 在 Qwen2-VL 的基础上,重新设计 Vision Encoder,引入 Window Attention、Dynamic FPS Sampling 和绝对时间对齐的 M-RoPE,提升高分辨率图像处理效率、视频时空理解和细粒度视觉定位能力,并通过多阶段预训练与后训练增强多模态推理能力
模型架构
整体由三个模块组成:
- Vision Encoder:使用重新设计的 ViT,提取图像和视频特征。
- Vision-Language Merger:将相邻的 2×2 Patch Features 拼接,通过两层 MLP 映射到 LLM 的特征维度
- LLM:使用预训练的 Qwen2.5 作为语言模型,接收视觉 Token 和文本 Token
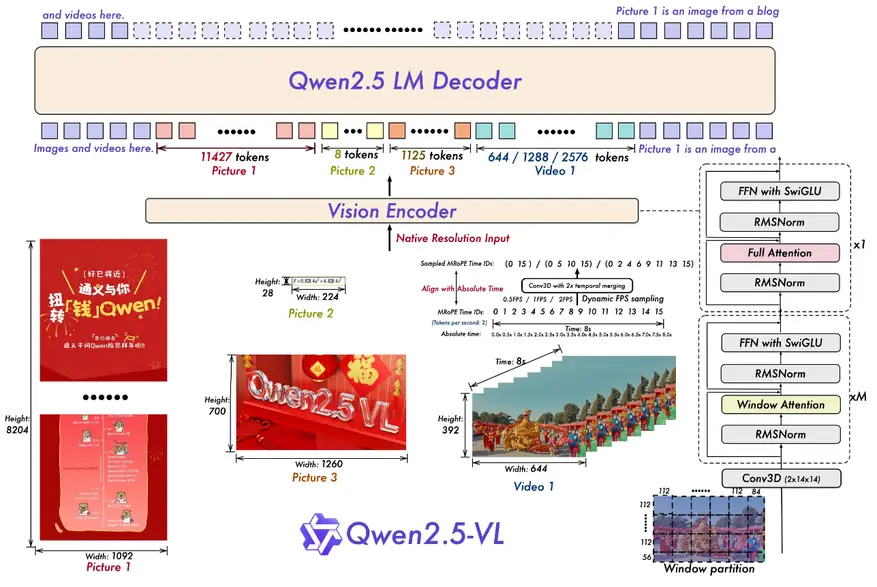
Fast and Efficient Vision Encoder
Qwen2-VL 使用全局 Self-Attention 处理视觉 Token,高分辨率输入会带来较大的计算开销
Qwen2.5-VL 引入 Window Attention,重新设计 ViT:
- 大部分 Transformer Layer 使用 Window Attention,只在局部窗口内进行 Attention
- 仅保留 4 个 Full Attention Layer,分别位于第 7、15、23、31 层
- Window Size 为 112×112,对应 8×8 个 Patch
- 引入 2D-RoPE 表示 Patch 的二维空间位置
- 使用 RMSNorm 和 SwiGLU,使 Vision Encoder 的结构更加接近 LLM
通过局部窗口计算降低 Attention 开销,同时保留少量全局信息交互
Dynamic Resolution & FPS Sampling
Qwen2.5-VL 将动态分辨率的思想进一步扩展到视频时间维度
1. Dynamic Resolution
- 保留图像原始宽高比
- 根据输入分辨率动态生成不同数量的 Visual Tokens
- 使用图像实际尺寸表示 Bounding Box 和 Point 坐标,而不是统一归一化到固定范围
2. Dynamic FPS Sampling
针对不同视频具有不同帧率的问题,在训练过程中动态调整视频采样 FPS,使模型能够适应不同时间采样密度的视频输入
使用 3D Patch Partitioning,将相邻两帧组合为时空 Patch,减少视频 Token 数量
M-RoPE Aligned to Absolute Time
Qwen2.5-VL 在 Qwen2-VL 的 M-RoPE 基础上,进一步改进时间维度的位置编码
原始 Qwen2-VL 的 Temporal ID 主要根据视频帧序号递增,没有直接表示真实时间间隔
Qwen2.5-VL 将 Temporal ID 与视频的绝对时间戳对齐:
- Temporal:根据视频帧对应的实际时间戳分配位置 ID
- Height:表示图像 Patch 的垂直位置
- Width:表示图像 Patch 的水平位置
通过不同 Temporal ID 之间的间隔,模型能够感知视频中的实际时间间隔和事件发生速度
核心改进: 从基于帧序号的位置编码,扩展为基于绝对时间的位置编码,使模型能够更准确地理解视频时序关系,并定位具体事件发生的时间
Pre-training
Qwen2.5-VL 将预训练分为三个阶段:
| 阶段 | Vision Encoder | LLM | 主要目标 |
|---|---|---|---|
| Stage 1 | 训练 | 冻结 | 视觉预训练 |
| Stage 2 | 训练 | 训练 | 多模态联合预训练 |
| Stage 3 | 训练 | 训练 | 长上下文预训练 |
- Stage 1:使用图像描述、视觉知识和 OCR 数据训练 ViT,学习视觉语义与文本之间的关联
- Stage 2:解冻全部参数,使用图文、视频、VQA、Grounding、Agent 等混合数据进行多模态预训练
- Stage 3:增加长视频、长文档和长序列数据,将训练序列长度扩展到 32768,增强长上下文理解能力
三个阶段分别使用约 1.5T、2T 和 0.6T Tokens,总计约 4.1T Tokens
Post-training
预训练完成后,进一步通过 SFT 和 DPO 增强模型的指令遵循与偏好对齐能力
| 阶段 | Vision Encoder | LLM | 训练目标 |
|---|---|---|---|
| SFT | 冻结 | 训练 | 多模态指令微调 |
| DPO | 冻结 | 训练 | 人类偏好对齐 |
SFT 让模型学会执行多模态指令,DPO 进一步优化模型的回答质量和行为表现
Qwen3-VL
核心思想: 在 Qwen2.5-VL 的基础上,引入 Interleaved M-RoPE、DeepStack 和文本时间戳等设计,增强多模态空间与时间建模能力、视觉语言特征融合和长上下文理解能力,并通过多阶段预训练与强化学习提升多模态推理能力
模型架构
整体延续三模块架构:
- Vision Encoder:采用 SigLIP-2 架构,提取图像和视频视觉特征
- Vision-Language Merger:使用两层 MLP,将相邻 2×2 Visual Features 合并并映射到 LLM 的特征维度
- LLM:使用 Qwen3 作为语言模型,接收文本和视觉 Token。
Interleaved M-RoPE
Qwen2.5-VL 使用 M-RoPE,将位置编码维度划分为 Temporal、Height、Width 三个部分
但这种划分会导致不同维度对应的 RoPE 频率分布不均衡,影响长视频的位置建模能力
时间维度 T 只能使用高频,而宽度维度 W 只能使用低频
Qwen3-VL 引入 Interleaved M-RoPE:
- 将 T、H、W 三个维度交错分布在不同的 RoPE 频率维度中
- 使三个维度均匀覆盖高频和低频位置编码
- 改善不同空间与时间维度的位置表达能力
DeepStack
传统视觉语言模型通常通过 Vision-Language Merger 将视觉特征映射到 LLM 的输入空间,再由 LLM 逐层处理视觉信息。
Qwen3-VL 引入 DeepStack,将 Vision Encoder 不同层级的视觉特征注入 LLM 的多个层级
具体过程:
- 从 Vision Encoder 的三个不同层级提取 Visual Features
- 使用专门的 Merger 将不同层级的特征映射到 LLM 的 Hidden Dimension
- 将这些视觉特征通过残差连接,分别注入 LLM 前三个 Transformer Layer
不同层级的 Vision Features 包含不同层次的视觉信息:
- 浅层特征:包含更多局部细节。
- 深层特征:包含更加丰富的语义信息。
核心作用: 不再只依赖单一层级的视觉特征,而是将多层次视觉信息直接融入 LLM 的不同层级,增强视觉语言对齐和细粒度视觉理解,同时不增加输入序列长度。
Video Timestamp
Qwen2.5-VL 使用与绝对时间对齐的 M-RoPE 表示视频时间信息,但存在两个问题:
- 长视频的 Temporal ID 可能变得非常大且稀疏,不利于长时间跨度的建模。
- 需要大量不同 FPS 的视频训练数据,增加数据构建成本
Qwen3-VL 改用 Text-based Timestamp:
- 在视频对应的每组视觉 Token 前添加文本时间戳
- 例如:
<3.0 seconds>。 - 同时使用秒数和 HMS(时:分:秒)两种时间格式进行训练
核心作用: 直接通过文本表示视频帧的时间位置,使模型能够理解事件发生的具体时间,增强 Video Grounding 和 Dense Video Captioning 能力
Pre-training
Qwen3-VL 将预训练划分为四个阶段,逐步完成视觉语言对齐、多模态学习和长上下文适配
- Stage 0:Vision-Language Alignment:冻结 Vision Encoder 和 LLM,仅训练 Merger,使视觉特征能够映射到 LLM 的特征空间
- Stage 1:Multimodal Pre-training:解冻全部参数,使用图文交错数据、VQA、Grounding、视频和文本数据进行联合训练
- Stage 2:Long-Context Pre-training:将序列长度扩展到 32K,增加长视频和 Agent 相关数据
- Stage 3:Ultra-Long-Context Adaptation:将序列长度扩展到 256K,增强长文档和长视频理解能力
另外,为了避免多模态数据训练影响 LLM 原有的文本能力,引入 Square-root Reweighting,平衡文本数据与多模态数据的训练贡献
Post-training
Qwen3-VL 的后训练主要分为三个阶段:
1. Supervised Fine-Tuning(SFT)
通过监督微调学习多模态指令遵循和复杂推理能力
- 使用普通指令数据训练 Non-thinking 模型
- 使用 Long Chain-of-Thought(CoT)数据训练 Thinking 模型
- 从 32K 上下文逐步扩展到 256K
2. Strong-to-Weak Distillation(蒸馏)
利用更强的 Teacher Model 向较小的 Student Model 迁移知识,增强推理能力
分为两个阶段:
- Off-policy Distillation:利用 Teacher 生成的回答训练 Student
- On-policy Distillation:Student 自己生成回答,再通过 KL Divergence 对齐 Teacher 和 Student 的预测分布
3. Reinforcement Learning(RL)
通过强化学习进一步提升模型的推理能力和任务执行能力,分为:
- Reasoning RL:针对数学、代码、逻辑推理、视觉定位等任务,利用可验证奖励优化模型
- General RL:针对 VQA、OCR、文档理解、指令遵循等任务,结合规则奖励和模型奖励,改善回答质量与行为表现