RAG 与知识检索系统
RAG 基础
[2005.11401] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
RAG:Retrieval-Augmented Generation
核心思想:将 LLM 的 Parametric Memory 与外部 Non-parametric Memory 结合
标准 RAG:
1 | Documents |
RAG 的主要价值:
- 使用企业私有知识
- 更新知识无需重新训练模型
- 可以提供 Evidence / Citation
- 降低纯参数知识带来的幻觉风险
企业知识库与文档处理
企业知识通常存在于:
1 |
|
RAG 的效果不仅由 LLM 决定,文档进入检索系统之前的处理往往同样重要
典型知识库构建流程:
1 | Raw Documents |
Document Parsing
文档解析的目标是把非结构化或半结构化文档转为能够索引和检索的数据
文本解析
普通文本 PDF 的基本流程:
1 |
|
但真实企业文档中经常还包括:
- 页眉页脚;
- 多栏布局;
- 表格;
- 公式;
- 图片;
- 扫描件;
- 章节层级;
如果解析阶段破坏文档结构,后面的 Embedding 和 Retrieval 很难补救
OCR
扫描文档首先需要 OCR
1 | Document Image |
单纯 OCR 只得到文字内容,但对于:
- 表格;
- 发票;
- 合同;
- 财报;
- 表单;
位置信息本身也是语义的一部分
[1912.13318] LayoutLM: Pre-training of Text and Layout for Document Image Understanding
LayoutLM 的核心思想是联合建模 Text 和 Layout,使模型不仅知道“写了什么”,还知道“写在哪里”
Document Parsing Evaluation
[2412.07626] OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations
文档解析质量不仅影响可读性,更直接影响 Chunk 边界、表格数值、引用页码与证据定位
需要对以下问题分别做测试:
- Reading Order:多栏文字是否按正确阅读顺序输出;
- Table Structure:是否保存行列、单元格合并与单位;
- Formula Extraction:是否能保留可解析的公式语义;
- Layout / Figures:图题、图文关联是否正确;
- Provenance:是否保存页面、坐标与来源,支持回答时定位证据。
OmniDocBench 提供多文档类型、不同版面类别和属性标签的解析评估基准,用于分析文档解析系统在不同文档及模块上的能力差异
Metadata
企业知识库不应该只有正文 Embedding,还需要保存 Metadata:
1 | Document ID |
Metadata 可以用于过滤:
1 | Semantic Retrieval |
Chunking
大模型通常不能直接将整个企业知识库放入 Context,因此需要把文档划分成 Chunk
Chunking 的本质是:在检索粒度和语义完整性之间做权衡
Fixed-size Chunk
按照固定 Token / Character 数切分
1 | Document |
优点:
- 简单
- 高效
- 容易实现
问题:
- 可能从一句话中间切断
- 可能破坏段落或表格结构
Overlap Window
给相邻 Chunk 保留重叠区域:
1 | Chunk 1: 1 -------- 500 |
Overlap 可以减轻边界信息丢失,但会:
- 增加索引量
- 增加重复召回
- 增加 Context 冗余
Recursive Chunking
优先按照自然结构切分:
1 | 章节 |
只有上一级结构过长时,才继续向下切分
Semantic Chunking
根据相邻文本的语义变化决定切分位置:
1 | Sentence Embeddings |
相比固定长度,Semantic Chunk 更强调内容完整性,但计算成本更高
Parent-Child Chunk
检索时使用小 Chunk,提高召回精度;最终返回其 Parent Context,保证生成时上下文完整
1 | Parent Document |
Late Chunking
[2409.04701] Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
常规策略通常是 先切分、再独立编码,每个 Chunk 的 Embedding 无法直接利用相邻片段中的信息
Late Chunking 先使用长上下文 Embedding 模型编码完整输入,再按 Chunk 对 Token Hidden States 执行 Pooling
因此,在做 Chunk-level Pooling 时,每个 Token 的表示可能已经融合了周边文档信息
信息抽取
知识库和知识图谱构建需要把自由文本转换成结构化信息
典型任务包括:
- Named Entity Recognition(NER,命名实体识别)
- Relation Extraction(关系抽取)
- Entity Linking(实体链接)
- Event Extraction(事件抽取)
- Structured Extraction(结构化抽取)
NER
NER 从文本中找到实体及其类型
1 | "OpenAI released GPT-4 in 2023." |
现代 LLM 也可以通过 Prompt + Structured Output 直接执行实体抽取
Relation Extraction
从实体之间抽取关系:
1 | OpenAI --developed--> GPT-4 |
结构化为 Triple:
1 | (head, relation, tail) |
Entity Linking
NER 解决的是“文本中哪里是实体”,但企业数据中还要解决:
1 | OpenAI |
是否指向同一个实体
因此需要 Entity Linking:
1 | Mention |
检索模型与向量索引
Embedding
Embedding 将文本映射成固定维度向量:
1 | "如何申请退款?" |
[1908.10084] Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks
Bi-Encoder 分别编码 Query 和 Document
1 | Query --------> Query Encoder --------> q |
因为 Document Embedding 可以提前离线计算,所以适合大规模检索
Cosine Similarity
模型训练
采用温度缩放对比学习方法
核心是利用以下四个概念:
- Positive:能正确回答 Query 的文档或 Passage;
- Random Negative:从无关文档中采样,训练早期较容易
- In-batch Negative:把同一 Batch 中其他 Query 的正例作为当前 Query 的负例
- Hard Negative:与 Query 很相似,但不满足相关性要求的候选
Hard Negative 往往更有训练价值,但要注意 False Negative:看似负例的文档其实也包含有效答案,强行拉远会损害表示空间。
现代 Embedding
[2506.05176] Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models
传统 Embedding 模型经常使用 BERT 等 Encoder-only 架构
Qwen3 Embedding 则基于具有 Causal Attention 的 Qwen3 模型
1 | Instruction + Query + [EOS] |
Query 编码时可以加入 Instruction,指定检索任务
依然是一种 Bi-Encoder 式检索架构,但底层使用了 Decoder-only LLM
Sparse Retrieval
Dense Retrieval 出现之前,信息检索系统主要依赖词项匹配
TF-IDF
基本思想:
- 一个词在当前文档中出现得越多,可能越重要;
- 一个词在所有文档中都很常见,则区分能力越弱。
BM25
Practical BM25 - Part 2: The BM25 Algorithm and its Variables | Elastic Blog
BM25 是经典 Sparse Retrieval 方法,核心考虑:
- Term Frequency;
- Inverse Document Frequency;
- Document Length Normalization。
其常见形式:
BM25 的优势是:
- 对关键词、专业术语、编号、产品型号非常敏感
- 不需要训练 Embedding Model
- 检索速度快
- 可解释性较强
缺点是:
- 难以处理同义表达
- 依赖词面匹配
Dense Retrieval
[2004.04906] Dense Passage Retrieval for Open-Domain Question Answering
DPR 使用 Dual Encoder 分别编码 Query 和 Passage:
BGE-M3 / M3-Embedding
传统 Embedding 模型通常只生成一个稠密向量,而 BGE-M3 使用同一个文本编码器的隐藏状态,构建三条检索分支
- Dense Retrieval:使用
[CLS]的隐藏状态作为整个文本的 Embedding,经过归一化后计算查询与文档的内积相似度 - Sparse Retrieval:利用一个可学习的线性层,将各 Token 的隐藏状态映射成词项权重。不是直接调用 BM25,而是模型学习词项重要性
- Multi-Vector Retrieval:不把整篇文本压缩成单个向量,保留 Query 和 Document 的 Token 级上下文向量,对每个 Query Token 计算其与所有 Document Token 的最大相似度
ANN Vector Search
知识库可能包含百万甚至上亿向量,不适合对所有向量执行 Exact Search $O(Nd)$
因此通常使用 Approximate Nearest Neighbor(ANN)
HNSW
HNSW:Hierarchical Navigable Small World
核心思想:建立多层近邻图
查询时:
1 | 高层快速定位大概区域 |
在每一层找最相似的,然后下一层看它的邻居
特点:
- Recall 高
- 查询速度快
- 内存开销较大
IVF
IVF:Inverted File Index
先把整个向量空间切成很多区域
先聚类,再只搜索相关的 Cluster
1 | All Embeddings |
每个 Cluster 有一个 Centroid
查询时先找到最接近的几个 Cluster,只在这些 Cluster 内搜索
Product Quantization
PQ 将高维向量拆成多个 Subspace,再分别量化,从而降低向量存储成本
1 | Vector |
这里类似 VQ-VAE,对每个 Subspace 单独训练 Codebook
常见组合:
1 | IVF + PQ |
用于在规模、内存和召回率之间折中
Hybrid Search
1 | Query |
Hybrid Search 的价值在于:
1 | BM25 |
两者互补
Reciprocal Rank Fusion
RRF 不直接比较两套系统的原始分数,而是根据 Ranking Position 融合:
Reranking
但 Top-K Retriever Result 的排序未必足够准确,因此通常增加第二阶段 Reranker
1 | 1,000,000 Documents |
Bi-Encoder:分别编码 Query 和 Document,向量相似度
Cross-Encoder:
1 | [Query ; Document] |
进行 Query 和 Document 的 Token-level Interaction,因此通常排序更准确
但每个 Query-Document Pair 都需要重新前向计算,成本更高
因此常见设计:
1 | Bi-Encoder Retrieval |
查询增强与上下文构建
Query Rewrite
例如用户存在上下文省略:
1 | 上一轮:QLoRA 是什么? |
Retrieval Query 可以改写成:
1 | QLoRA 和 LoRA 有什么区别? |
Multi-Query
让 LLM 生成多个不同角度的 Query
1 | Original Query |
可以提高 Recall,但同时增加检索成本和噪声
HyDE
[2212.10496] Precise Zero-Shot Dense Retrieval without Relevance Labels
Hypothetical Document Embeddings
核心思路:
1 | User Query |
不直接 Embed 短 Query,而是先生成一个“可能的答案文档”,再用它的语义空间去搜索真实语料
Context Construction
Retriever 输出 Top-K 之后,还需要构造最终 Prompt Context
Lost in the Middle
[2307.03172] Lost in the Middle: How Language Models Use Long Contexts
长 Context 并不意味着模型能够均匀利用所有位置的信息
模型对长上下文中信息的位置非常敏感:当关键信息位于上下文开头或结尾时,任务性能通常最高;位于中间时,性能显著下降
1 | Question |
保持:
1 | Question 不变 |
只改变包含答案的 Document 在 Context 中的位置
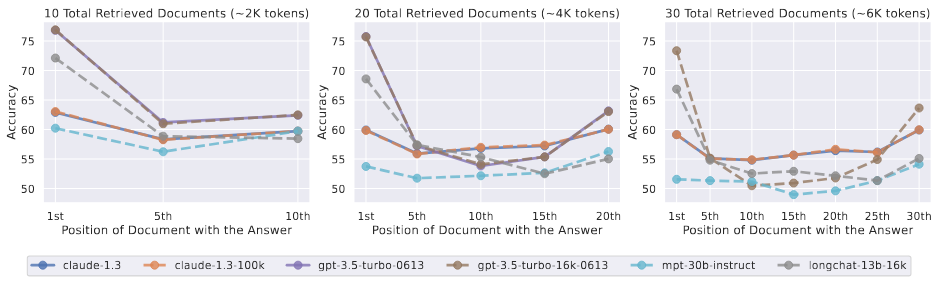
即使正确信息确实已经进入 Context,模型也不一定能够稳定地访问和利用它
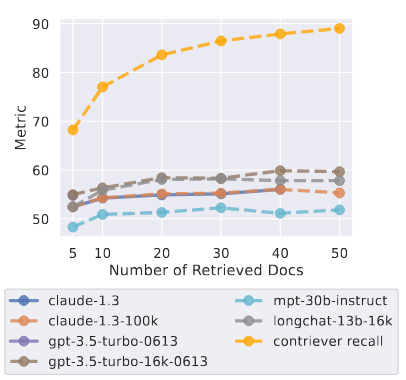
并且模型的性能在文档数量达到一定时就饱和了
Context Compression
即使 Retriever 找到正确材料,最终的 Context 仍可能混入重复内容、相互矛盾版本或无关段落
常见处理顺序:
1 | 检索候选片段 |
压缩不能改变原始证据含义
Advanced RAG
Self-RAG
[2310.11511] Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection
传统 Naive RAG 通常采用固定流程:
1 | Query |
但不是所有问题都需要检索,而且 Retrieval Result 也不一定相关
Self-RAG 引入 Self-Reflection,使模型能够学习判断
1 | Query |
Retrieval 不再是固定步骤,而是可根据问题和证据质量动态触发
CRAG
CRAG 关注的问题是:如果 Retriever 本身找错了文档怎么办?
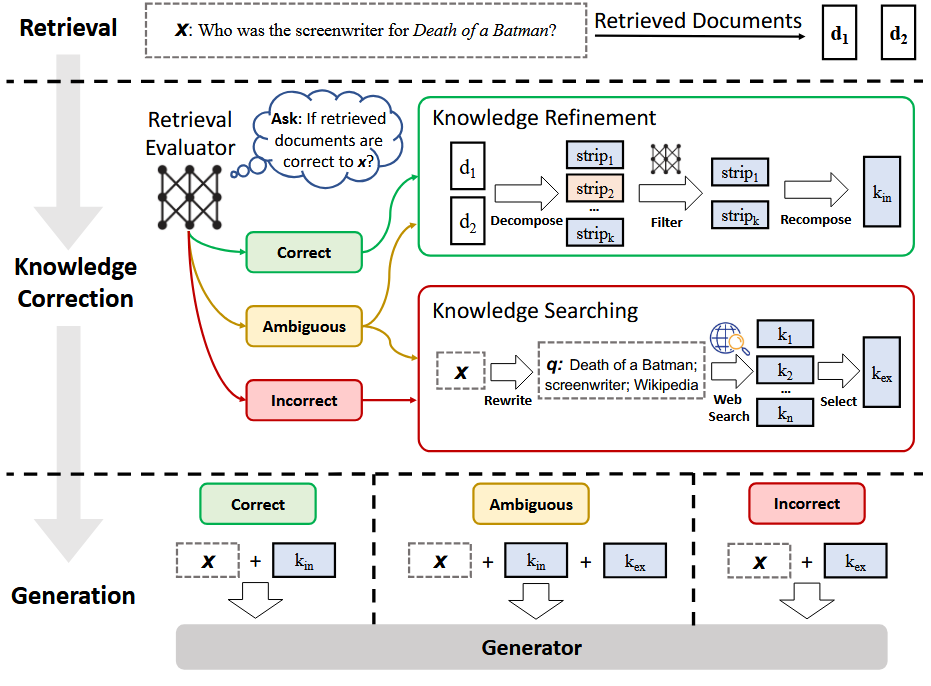
CRAG 使用轻量的 Retrieval Evaluator 判断检索结果质量,并根据置信程度采取不同的知识修正策略;不只是过滤低质量 Chunk
先评价检索质量,再决定是否使用额外知识源或精炼证据
GraphRAG
[2404.16130] From Local to Global: A Graph RAG Approach to Query-Focused Summarization
普通 RAG 主要依赖:
1 | Query |
非常适合局部事实问题
但对于 Global Question 单纯 Top-K Chunk 很难覆盖整个 Corpus
GraphRAG 的核心思路:先从文档中抽取 Entity 和 Relation,构建知识图谱,再利用图结构进行检索和聚合
GraphRAG 最重要的是 Indexing 阶段,索引构建比普通 RAG复杂很多
Local Search
围绕某个 Entity 的具体问题
1 | Local Question |
先定位节点,再沿图扩展邻居
Global Search
1 | Query |
适合:
1 | “整个数据集有哪些主要主题?” |
Multimodal RAG
传统 RAG:
1 |
|
这种方式可能丢失:
- 表格结构
- 图像语义
- 页面布局
- 文本与图像对应关系
Visual Document Retrieval
[2407.01449] ColPali: Efficient Document Retrieval with Vision Language Models
ColPali 的思路不再要求先将页面完全转换成纯文本,而是直接对 Document Page Image 生成 Multi-vector Representation
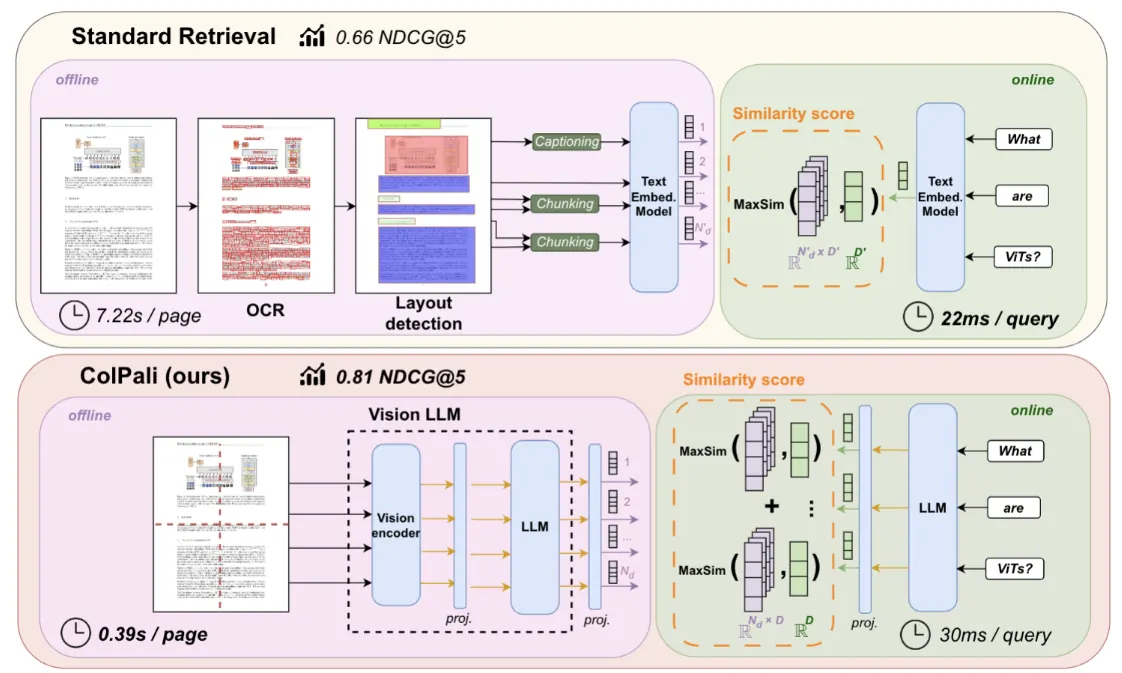
这样能够保留:
- Layout;
- Table;
- Figures;
直接将 Document Page 作为 Image 编码,在 Vision Space 中执行 Retrieval
ColPali 通过视觉语言模型将页面图像映射为多个视觉 Patch 表示,将 Query 映射为多个 Token 表示,并使用细粒度的 Late Interaction 计算匹配分数
多向量表示能保留局部图文细节,但索引、查询内积数量与存储压力通常高于单向量检索
检索与生成评估
Failure Modes
可以把 RAG 的错误拆成三个阶段:
1 | Query |
Retrieval Error
正确文档根本没有被召回
可能原因:
- Chunk 太大 / 太小
- Query 与 Document 表述差异大(最常见原因)
- Embedding Model 不适合
- Top-K 太小
- 缺少 Keyword Retrieval
- Metadata Filter 错误
Context Error
正确文档已经召回,但最终送入模型的 Context 不合适
可能原因:
- overlap 很大,大量内容重复
- 无关内容太多
- Chunk 顺序差
- 重要 Evidence 被截断
Generation Error
Evidence 已经正确,但模型仍然:
- 忽略证 Evidence
- 错误归纳
- 混合多个文档
- 产生无来源事实
因此 RAG 优化不能只看最终答案,必须分别评估 Retriever、Reranker 和 Generator
Retrieval Metrics
Recall@K
如果一共存在 $N_{rel}$ 个 Relevant Documents,Top-K 中找到了 $N_{hit}$ 个:
Precision@K
MRR
MRR:Mean Reciprocal Rank。
对每个 Query,关注第一个 Relevant Document 的排名:
Hit@K
对于每个 Query,只要 Top-K 中至少命中一个相关证据,就记作 1,否则记作 0: